离线环境部署 AI Agent 前置准备:硬件算力、离线镜像包与网络隔离清单
在完全物理隔绝或单向受控的企业内网中部署大模型与智能体,常常因缺驱动、缺基础镜像、缺内网依赖源、机房网络策略不通导致现场交付严重延期。围绕离线机房环境准备、GPU/NPU 算力与存储底座评估、离线容器镜像与模型权重封包校验、私有依赖仓同步,以及最小权限网络穿透清单,梳理一套可直接用于工程交底的智能体私有化前置就绪规范。
在政企机房、涉密内网或工业物理隔离网络中,私有化部署企业大模型与 AI Agent 面临的最严峻挑战往往不是算法调优,而是“无网环境下的工程交付断层”。公网一条 pip install 或 docker pull 只需数秒,而在纯离线内网中,缺少一个系统动态链接库、宿主机内核与显卡驱动版本不兼容、缺少离线基础镜像,或是未提前开通内网服务访问端口,都会直接导致交付团队在机房现场陷入长时间停滞。本文围绕离线私有化交付的真实工程场景,系统梳理进场前必须完成的基础设施准备:从 GPU/NPU 算力与显存吞吐规划、宿主机驱动固件与容器运行时、大模型权重与容器镜像的离线分卷封装,到最小可用网络穿透拓扑与五步前置就绪交底清单,为企业技术架构与运维团队提供一份开箱即用的前置准备指南。
为什么离线部署最怕“现场抓瞎”:物理隔离下的工程依赖断层
许多企业在推进大模型智能体项目时,往往在研发阶段习惯了公网连通的开发体验。然而一旦进入生产级的物理隔离或单向网闸机房,基础设施的底层环境将发生根本性变化:
- 隐式动态依赖与“套娃式”缺失:现代大模型推理框架(如 vLLM、TGI、Ollama)以及 Agent 执行底座不仅依赖数百个 Python 第三方包,更深度绑定 CUDA/CUDNN、NCCL 分布式通信库、特定版本的 Glibc 和 Linux 内核头文件。如果在离线导入时仅打包了应用层代码,现场极易遭遇
version `GLIBC_2.34' not found或缺少libcublas.so等底层链接错误,导致容器反复崩溃退出。 - 模型权重体积庞大与介质拷贝瓶颈:全参数或量化后的开源大模型权重文件通常在十几 GB 至数百 GB 之间。在完全物理隔离的网络中,数据导入必须经由经加密与杀毒审查的安全移动介质(或内网光闸)。若未在进场前完成哈希校验和与分卷校验,现场拷贝过程中一旦发生单 bit 校验损坏,在机房现场重新传输将耗费数小时甚至数天。
- 跨网段与多系统端口策略审批周期长:AI Agent 不是孤立的对话工具,其核心价值在于调度业务系统的工具与数据库。在等保三级及以上的企业网络拓扑中,智能体推理服务器通常部署在专用的 AI 计算区,而 ERP、MES 或 OA 系统则位于核心业务内网。若未提前梳理端口白名单与域名解析规则,进场后发起临时跨网段开墙流程往往需要跨多个部门审批数周,造成“机器已就绪、业务全不通”的尴尬局面。
硬件算力与宿主机底座:GPU/NPU 选型、显存余量与高速存储规划
在离线环境下部署大模型智能体,算力与存储底座是不可动态弹性扩容的物理约束。必须在进场前依据并发预期、模型上下文窗口(Context Window)以及 Agent 多轮推理特征精确核算:
- 静态显存与动态 KV Cache 开销测算:大模型运行时的显存占用由两部分构成:模型权重静态显存与推理运行时的 KV Cache 动态显存。以 32B 参数模型(FP16 精度约为 64GB 权重,或 INT4/AWQ 量化约为 18-20GB 权重)为例,当智能体开启长上下文(如 8K-32K Tokens 用于文档检索与工具入参推理)且维持 5-10 个并发会话时,KV Cache 将额外消耗 16-32GB 显存。因此,单节点至少需规划 80GB 显存(如单卡 80GB 或双卡 48GB 拓扑),并保留至少 20% 的显存余量以防 OOM(Out Of Memory)。
- 宿主机内存与 PCIe/NVLink 带宽要求:宿主机物理内存容量一般应为 GPU 总显存的 2 至 3 倍(建议 256GB 起步),以保证在模型冷启动加载、权重切片与多进程预热时具备充足的页缓存空间。多卡部署时应优先确认主板支持 NVLink 高速互联或至少 PCIe 4.0/5.0 x16 槽位,避免因卡间张量并行(Tensor Parallelism)通信瓶颈导致每秒 Token 生成速度剧降。
- 本地 NVMe 存储吞吐与 IOPS 规划:严禁将大模型权重及向量数据库挂载在千兆或低性能 NFS 网络存储上。模型服务冷启动时需要从磁盘读取数十 GB 文件,若读取速度仅为 100MB/s,单次重启将耗时数十分钟;生产环境应配置独立的企业级 NVMe SSD 阵列(顺序读取性能建议大于 3500MB/s,随机读 IOPS 大于 200K),并为日志、向量索引持久化预留至少 2TB 的可用空间。
操作系统与基础设施准备:驱动固件、容器运行时与内网私有 Registry
宿主机的底层操作系统环境与驱动固件必须在进场前固化并形成基线,严禁在现场直接通过联网脚本动态安装:
- 操作系统版本与内核基线对齐:推荐采用企业级主流长期支持版 Linux(如 Ubuntu 22.04 LTS 或 Kylin/Euler/RedHat 兼容内核)。确认宿主机关闭了系统自动内核升级功能(禁用
unattended-upgrades),防止操作系统静默更新内核后导致第三方显卡驱动模块失效。 - 离线驱动包与容器工具包(NVIDIA Container Toolkit)准备:提前下载与目标硬件平台严格匹配的驱动离线
.run文件或离线 deb/rpm 包。部署容器化智能体时,必须配套准备并安装好容器运行时工具包(如nvidia-container-toolkit或对应国产 NPU 的运行时库),确保 Docker/Containerd 能够通过--gpus all参数直接将底层加速卡安全透传至容器内部。 - 企业内网私有镜像仓库(Private Registry / Harbor)搭建:离线机房应提前就绪内网可寻址的 Harbor 或轻量级 Docker Registry。提前配置内网所有计算节点的
/etc/docker/daemon.json,配置不安全仓库凭据(或统一分发内网自签名 CA 证书),使宿主机具备自内网高速拉取全套业务镜像的能力,彻底替代零散的手工docker load操作。
模型权重与依赖资产封包:离线分卷打包、校验和与安全传输
软件栈和模型权重的离线装箱是一门精细的工程技术。一个合格的离线交付物包必须具备自包含、可验证与防破坏特性:
- 基于 OCI 规范的全量容器镜像封包:业务系统、Agent 编排引擎、向量数据库(如 Milvus/Qdrant/PgVector)以及前置脱敏网关应全部制作成独立的自包含 Docker 镜像。在外部构建机上执行
docker save时,建议按模块分类归档,并使用pigz等多线程工具压缩为.tar.gz格式。 - 模型权重分卷归档与 SHA256 校验和清册:对于动辄上百 GB 的大模型权重目录(包含
.safetensors、config.json、tokenizer.model等文件),严禁整体单文件打包。应使用split命令按 10GB-20GB 规格进行定长分卷,并针对原始文件与每个分卷文件生成SHA256SUMS校验文件。数据导入内网后,先执行sha256sum -c SHA256SUMS完整性校验,确认无损坏后再行解压或合并。 - 全量离线 Python/Node 依赖 Wheels 与 OS 包底库:虽然核心服务通常容器化运行,但现场运维工具、健康巡检脚本或二次开发插件仍可能需要解释器环境。交付介质中应携带全量离线 Python Wheel 包(通过
pip download -d ./wheels -r requirements.txt生成)以及系统工具离线包,确保机房内无需任何外网反向代理即可就地排障。
最小可用网络拓扑与端口策略:内网穿透白名单与跨网段集成
在企业物理隔绝网络中,AI Agent 既要保证内部各组件通信畅通,又要受控访问各类现有业务系统,网络拓扑规划必须遵循最小权限原则:
- 计算集群内部通信拓扑:智能体应用网关(API Gateway)、大模型推理服务(如 8000 端口)、向量检索库(如 19530 端口)、元数据数据库(如 PostgreSQL 5432 端口)以及缓存服务(如 Redis 6379 端口)应划归在同一专用业务 VPC 或子网 VLAN 中。节点间开启必要的高性能 RPC 通信端口,关闭公网默认管理端口。
- 跨网段业务系统集成访问白名单:Agent 在执行 Tool Calling 时需要对接 ERP、MES、OA 或企业内部知识库。运维团队必须在进场前至少两周提交防火墙安全策略工单,申请推理网段向业务系统目标 IP 的特定端口(如 HTTP/HTTPS 443、8080 等)单向或双向放行,并明确约定超时与重试规则。
- 内网 DNS 解析或静态 Hosts 固化:企业内网若未配置统一的内网 DNS 服务器,智能体在解析业务系统域名(如
oa.corp.internal)时会因解析超时引发异常。必须在准备阶段明确各业务系统的内网域名、静态 IP 地址分配方案,并在容器编排文件(如 docker-compose 或 Kubelet 配置)中通过extra_hosts显式固定解析映射。
实施交付五步前置就绪清单:进场实施前的交底标准
为确保离线私有化部署工程进场即开工、开箱即联调,建议双方实施与运维负责人对照以下五步清单逐一核验签署:
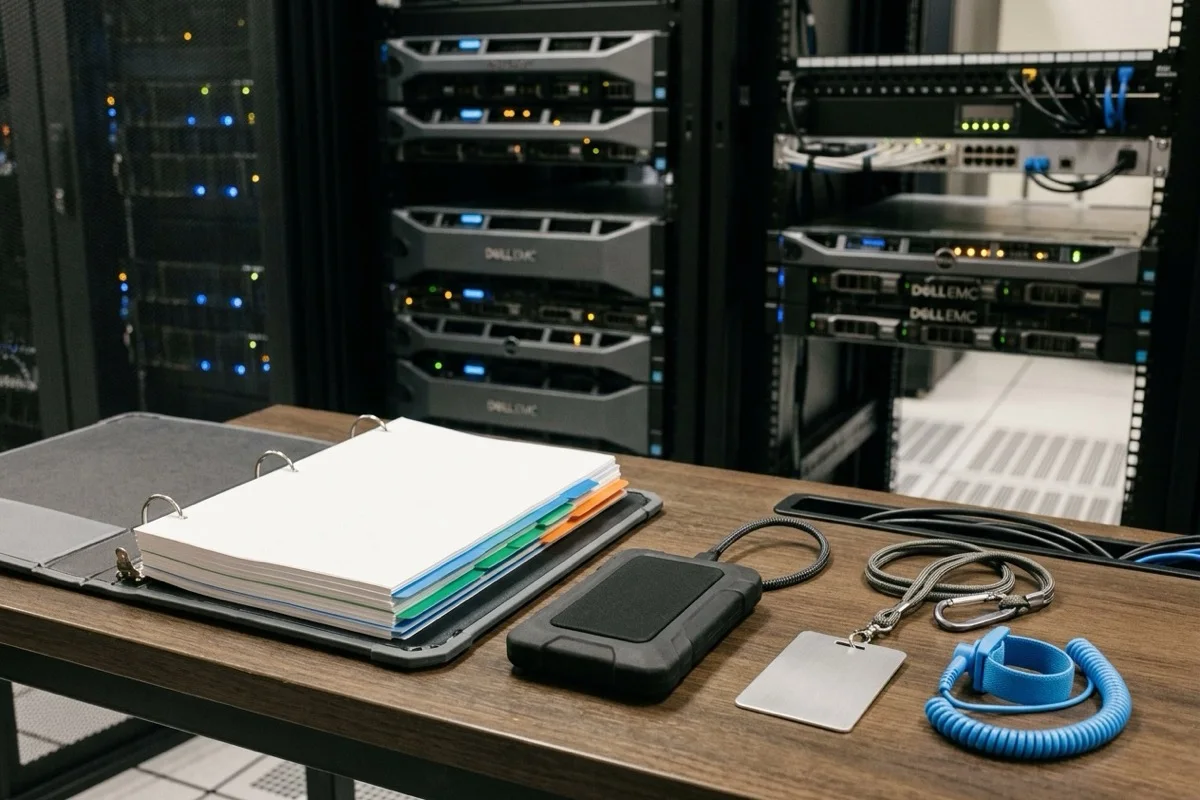
【交底核验】AI Agent 离线私有化前置就绪核查表:
- 第一步·机房物理与硬件验收:核实服务器已就位上架并接通双路冗余电源;GPU/NPU 卡已正确识别且散热正常;NVMe 本地高速存储空间格式化完毕(空闲挂载点大于 2TB)。
- 第二步·系统内核与加速驱动基线锁死:确认 Linux 内核版本固定且已关闭自动升级;显卡驱动及
nvidia-container-toolkit已正确安装并通过nvidia-smi验证;Docker/Containerd 运行时就绪。 - 第三步·离线介质安全导入与完整性对账:交付介质(移动硬盘或光闸摆渡数据)通过安全杀毒扫描;全部镜像包、模型权重分卷包与离线依赖库的 SHA256 校验和 100% 匹配无误。
- 第四步·内网网络策略与接口连通性前置拨测:防火墙跨网段安全策略已开通生效;从 AI 计算区宿主机执行
curl或nc -zv拨测 ERP/MES/OA 目标接口与内网 DNS,确认网络链路零丢包、低延迟。 - 第五步·服务账号与业务接口凭据备齐:OA/ERP/MES 系统的专用集成服务账号、短期授权密钥及接口文档已完成内网交付,并确认账号具备受控调用的业务权限边界。
参考标准与适用边界
本规范所涉及的离线基础设施准备与网络隔离要求,参考并结合了以下国家法规与技术工程规范:
- 《中华人民共和国数据安全法》第二十七条:开展数据处理活动应当依照法律、法规的规定,建立健全全流程数据安全管理制度,组织开展数据安全教育培训,采取相应的技术措施和其他必要措施,保障数据安全。
- 工业和信息化部等六部门《算力基础设施高质量发展行动计划》(工信部联通信〔2023〕180号):加强算力基础设施安全可靠建设,完善软硬件适配验证体系,推进算力中心容灾备份与物理安全防护。
- GB/T 22239-2019《信息安全技术 网络安全等级保护基本要求》:针对第三级安全计算环境中的“边界防护”与“访问控制”,明确要求内部不同网络区域之间应设置访问控制策略,严格限制跨区端口流向与非必要服务。
- OCI 镜像规范(Open Container Initiative Image Format Specification):确保所有离线分发的容器镜像遵循跨平台标准结构与文件清单哈希验证机制。
在适用边界方面,本文给出的显存规划与依赖封包方案适用于企业常见的 7B 至 72B 参数规模大模型与单节点/小规模多节点私有化智能体部署。超大规模分布式集群(如数百卡规模)在 IB(InfiniBand)高速无损网络与并行存储拓扑上存在更复杂的物理布线与 RoCEv2 调优要求,企业应根据自身机房基础条件与业务并发规模合理调整方案实施细则。