大模型企业私有化推理加速:推测解码(Speculative Decoding)与 Draft Model 协同架构实战
针对企业在私有化机房部署 70B/32B 大模型智能体时面临的单请求自回归解码延迟高、每秒生成 Token 数受限于显存带宽物理上限(Memory-bound)、多轮 Agent 复杂推理体验卡顿等核心瓶颈,系统剖析推测解码(Speculative Decoding / 投机采样)的核心机理,深入探讨 Draft Model 草稿模型与 Target Model 目标模型协同流水线、无损拒绝采样(Rejection Sampling)概率对齐算法、无独立草稿模型的自推测多头架构(Medusa / Eagle),并给出企业私有化算力条件下的接受率(Acceptance Rate)评估、显存配比与工程落地选型矩阵。
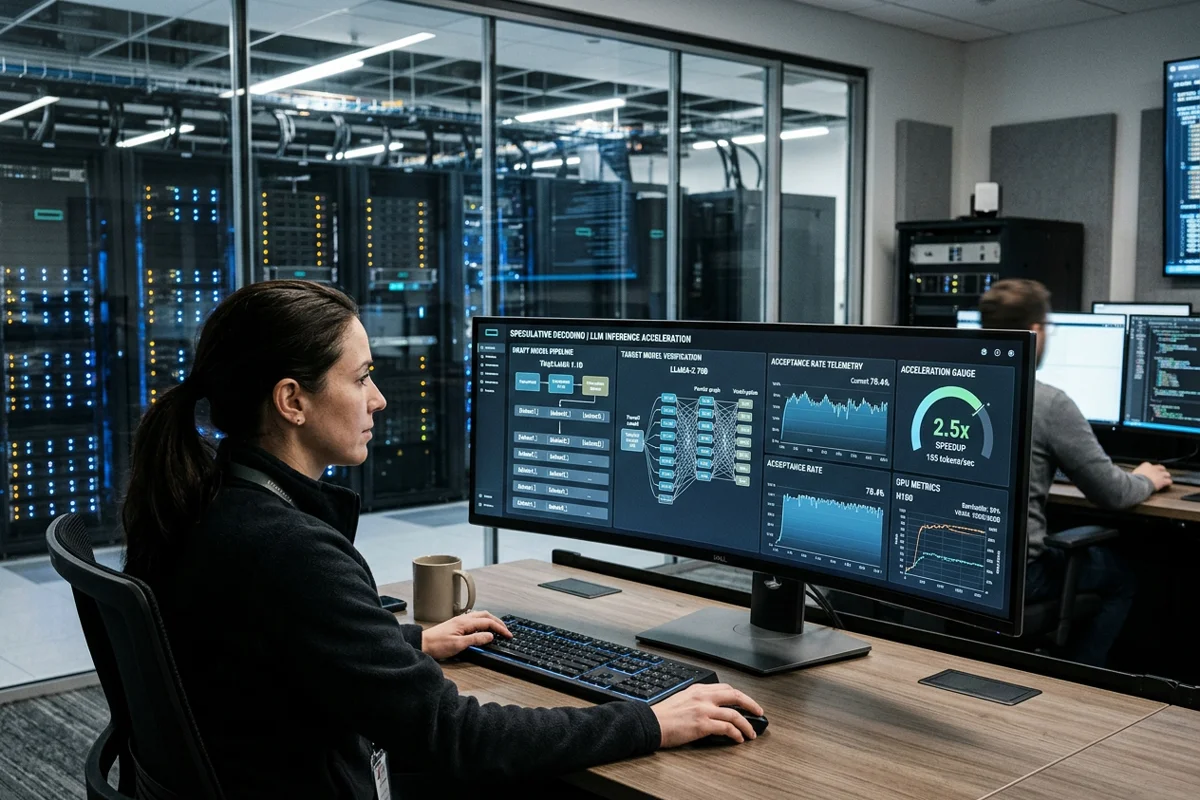
随着大模型与复杂智能体在企业私有云及本地数据中心深度落地,企业在追求多轮规划(Planning)、复杂工具链调用(Tool Calling)与长思维链(Chain-of-Thought, CoT)时,普遍遭遇严峻的交互体验与计算效率瓶颈:单请求每秒生成的 Token 数过低,首字之后的流式生成等待时间拉长,导致面向严肃业务的业务人员与交互系统面临严重的卡顿感。许多企业在斥资采购高性能 GPU 硬件(如 8×A100/H800 或国产高性能计算卡)后发现,即便 GPU 的张量计算核心利用率(Tensor Core Utilization)仅徘徊在 20%~30%,Token 的生成速率依然无法突破每秒 25~40 个的物理天花板。深入分析底层计算流可知,生成式自回归(Autoregressive)解码属于典型的显存带宽受限(Memory-bound)任务,每次生成单 Token 都必须将几十 GB 的模型全量权重从高带宽显存(HBM)搬运至计算缓存中。针对这一硬核物理瓶颈,推测解码(Speculative Decoding / 投机采样)通过“小模型草稿快速推测、大模型单步前向并行校验”的时空置换架构,在严格数学无损(Zero Loss of Quality)的前提下实现了 2~3 倍的生成速率跃升。本文结合百信企业智能体平台在私有化推理引擎架构中的落地实战,系统剖析推测解码的底层机理、拒绝采样数学对齐、自推测架构演进以及企业级参数调优实战,并提供生产级模拟调度器代码实现。
自回归解码的物理诅咒:显存带宽墙与 Memory-bound 瓶颈剖析
在企业私有化大模型推理引擎中,许多研发工程师容易将推理延迟等同于“算力不足(FLOPS 瓶颈)”。然而,根据现代计算机体系结构中的 Roofline 性能模型,计算任务受限于两大物理边界:算力峰值(Compute Peak)与显存带宽峰值(Memory Bandwidth Peak)。大模型的生命周期被严格划分为两个阶段:预填充阶段(Prefill Phase)与解码阶段(Decoding Phase)。
1. 算术强度(Arithmetic Intensity)的断崖式下跌
算术强度定义为每次显存数据搬运(Byte)所能执行的浮点运算次数(FLOPs/Byte)。硬件平台存在一个算力平衡临界点(Hardware Balance Point):当算法的算术强度高于临界点时,任务由计算核心饱和度决定(Compute-bound);反之,任务被显存数据搬运速率锁死(Memory-bound)。
| 推理阶段 | 输入张量特征与算子类型 | 典型算术强度(FLOPs/Byte) | 物理瓶颈归宿 | 典型 GPU 算力利用率 |
|---|---|---|---|---|
| 预填充阶段(Prefill / Prompt) | 一次性处理用户长 Prompt(如 2048 Token),属于矩阵乘矩阵(GEMM)计算。 | 约 500 ~ 1500 FLOPs/Byte(显著高于硬件临界点) | 算力受限(Compute-bound) | 60% ~ 85%(Tensor Core 充分跑满) |
| 自回归解码阶段(Decoding / Token Gen) | 单请求每次只输入上一个 Token(Batch=1 时序列长度为 1),属于矩阵乘向量(GEMV)计算。 | 约 1 ~ 2 FLOPs/Byte(远低于 A100 的 150 FLOPs/Byte 临界点) | 显存带宽受限(Memory-bound) | 5% ~ 15%(算力核心大部分时间处于空等 HBM 搬运) |
以一个 70B FP16 参数模型(权重大小约 140 GB)部署在单台配有 2000 GB/s HBM 带宽的高端 GPU 服务器为例:若单批次解码仅处理 1 个 Token,每生成 1 个 Token 都必须将 140 GB 权重完整读入 SRAM 一次。理论最短物理耗时为:
物理极限延迟 = 140 GB ÷ 2000 GB/s = 70 毫秒/Token
理论生成上限 = 1 ÷ 0.070 秒 ≈ 14.3 Token/s
在这一模式下,无论 GPU 拥有多么恐怖的 TFLOPS 浮点峰值,昂贵的计算核心都在无尽地等待显存数据加载。要想让单请求的 Token 生成速率突破这一物理诅咒,唯一的数学通路是:让每一次耗资巨大的全量权重显存搬运,产生不止 1 个 Token 的前向成果。
推测解码(Speculative Decoding)核心机理:以计算换带宽的时空跃迁
2023 年,由 Google Research(Leviathan et al.)与 DeepMind(Chen et al.)各自独立提出的推测解码(Speculative Decoding / Speculative Sampling),彻底颠覆了自回归逐字生成的传统范式。
1. 双模型协同流水线架构
推测解码引入了双模型角色分工协作:
- 草稿模型(Draft Model,又称小模型 Mq):参数量通常只有目标模型的 1%~5%(例如 1B~3B 参数),其自回归生成单 Token 仅需搬运极少的权重,因而生成速率极快(通常为 100~200 Token/s);
- 目标模型(Target Model,又称主模型 Mp):企业私有化部署的大参数严肃主干模型(如 32B~70B 参数),其生成质量高、遵循意图严谨,但自回归单步极其昂贵;
- 推测步长(Lookahead Window K):每轮推测中,草稿模型连续自回归预测生成的候选 Token 数量(通常设置为 3 到 6 个)。
| 执行步骤 | 执行主体 | 操作细节与显存行为 | 计算复杂度与耗时特征 |
|---|---|---|---|
| 步骤一:草稿快速推测 | Draft Model (Mq) | 基于当前上下文,连续自回归生成 K 个后续候选 Token。同时保存每步草稿概率分布。 | 轻量极快。由于小模型权重体积小,耗时仅占整个轮次的 15%~25%。 |
| 步骤二:主模型并行核验 | Target Model (Mp) | 将草稿预测的 K 个 Token 连同原前缀拼接,作为序列单次送入主模型执行并行前向传播(Forward Pass)。 | 单次全量权重搬运。在一次前向中同时计算出 K+1 个位置的大模型条件概率分布。 |
| 步骤三:拒绝采样决策 | 验证调度器(Speculative Engine) | 按顺序依次比对草稿概率与主模型概率。若全部接受,可一轮输出 K+1 个 Token;若在第 j 个被拒绝,则修正该 Token 并截断后续。 | 纳秒级 CPU/GPU 标量计算。决定最终保留的 Token 序列与 KV Cache 回滚位点。 |
推测解码的本质,在于利用大模型单次前向能够并行处理长度为 K 的序列(GEMM 算术强度大幅提升)这一物理事实,用极小的额外计算量替代了多次昂贵的显存权重全量搬运。只要草稿模型的预测准确度(接受率 α)足够高,每轮主模型前向就能确认多个有效 Token,从而实现生成速率的成倍跃升。
数学无损保证:拒绝采样(Rejection Sampling)与目标分布概率对齐算法
在企业严肃业务系统(如财务审批、医疗辅诊或合同审查)中,技术架构师最为关切的核心问题是:推测解码是否会牺牲大模型的输出质量?是否会导致推理结果降级?
答案是:严格数学无损(Mathematically Exact)。推测解码输出的文本概率分布,与直接由大模型自回归采样生成的理论概率分布完全不可区分(Identical Distribution)。这一严谨性质由特定的拒绝采样(Rejection Sampling)修正机制所证明。
1. 贪心解码(Greedy Search)场景下的等价性
在温度参数 T=0 的确定性解码场景中,判定规则极度直观:
接受条件: 当且仅当 argmax(p_i) == draft_token_i 时,Token 被接受。
一旦遇到 argmax(p_j) != draft_token_j,则拒绝 draft_token_j,将第 j 个 Token 强制纠正为 argmax(p_j),并丢弃 j 之后的全部草稿。
显而易见,所有被接受的 Token 都与主模型贪心选择完全一致,而被拒绝的第 j 个 Token 也被替换为了主模型的贪心输出。因此,生成的整个序列与主模型独步贪心生成的序列 100% 完全相同。
2. 随机采样(Stochastic Sampling)场景下的概率修正分布
在 T > 0 的非确定性采样场景中,若仅因小模型概率低就盲目丢弃,会导致高频词过度膨胀。推测解码通过如下概率准则进行严格的无偏采样:
- 单步接受概率公式:对于草稿模型采样的候选 Token,接受该 Token 的概率定义为:P(Accept x) = min(1, p(x) / q(x))若 p(x) >= q(x),说明主模型比草稿模型更认可这个词,则100% 必然接受;若 p(x) < q(x),则以两者的比值作为概率进行掷骰子决定是否接受。
- 拒绝修正残差分布(Residual Distribution):若候选词在上述判定中被拒绝,系统不能退回重新跑,而是直接从如下残差归一化分布 p'(x) 中重新抽取一个替代 Token:p'(x) = max(0, p(x) - q(x)) / sum_y(max(0, p(y) - q(y)))
数学证明简述:根据全概率公式,最终输出词 x 的综合边际概率分布为:
P(output = x) = q(x) * min(1, p(x)/q(x)) + (1 - beta) * p'(x)
             = min(q(x), p(x)) + max(0, p(x) - q(x))
             = p(x)
式中 beta 为整体接受率。计算结果严格恒等于主模型自身的原始概率分布 p(x)。这意味着,无论草稿模型的质量多差,推测解码都不会产生哪怕一丝一毫的“模型幻觉放大”或输出分布漂移;草稿模型的劣质只会降低接受率,使加速比回退到 1.0x,但绝不会损害最终文本质量。
免独立小模型的自推测进化:Medusa 多头预测与 Eagle 树状注意力加速
尽管标准的 Speculative Decoding 架构极其优雅,但企业在私有化机房落地时往往面临两个运维痛点:
- 词表对齐与架构强依赖:草稿模型与主模型必须拥有完全相同的 Tokenizer 词表与编码规则,否则 Token ID 无法直接对齐;
- 额外显存常驻与双模型调度:在 4 卡或 8 卡显存已经紧张的私有化服务器中,额外常驻一个 1B~3B 的小模型会挤占 2~6 GB 宝贵的 KV Cache 显存池,并增加推理框架多实例协同的复杂性。
为了解决上述痛点,业界演进出了自推测解码(Self-Speculative Decoding)与无草稿模型加速架构,其中最具代表性的是 Medusa(美杜莎多头架构)与 Eagle(树状注意力外推)。
| 加速技术方案 | 草稿生成载体 | 树状注意力与候选拓扑 | 私有化显存开销 | 工程落地适用场景 |
|---|---|---|---|---|
| 经典双模型推测解码 (Vanilla SpecDec) | 独立小模型(如 Qwen2.5-0.5B 辅助 72B) | 线性链状推测序列(串行 K 个 Token) | 需额外加载小模型全量权重(2~6 GB 显存) | 现成开源小模型与大模型同源同词表,免训练即插即用 |
| Medusa (美杜莎多头架构) | 在主模型最后一层附加多个轻量级 MLP 头 | 树状拓扑(Tree Attention),同时核验多种候选路径组合 | 极低(仅增几个线性层权重,通常 < 200 MB) | 对显存极度敏感、无法容纳独立小模型的私有化卡集群 |
| Eagle (特征层自回归加速) | 结合主模型顶层隐藏状态(Hidden State)自回归 | 动态多分支树注意力,上下文适应力极强 | 低(仅单个单层 Transformer 结构,< 500 MB) | 智能体长文本生成、代码生成与高接受率复杂 CoT 推理 |
| Lookahead Decoding (基于 N-gram 的无损自推测) | 无需训练,直接从当前生成的历史序列提取 N-gram 缓存 | 局部 N-gram 窗口展开并行验证 | 零额外显存占用(Zero GPU Memory Overhead) | 严禁任何附加微调、算力卡显存已达 98% 极限的企业环境 |
通过树状注意力(Tree Attention Mask),推理引擎能够在一个单步主模型前向中,同时验证 32 到 64 条不同的候选分支。只要其中任何一条分支被命中,整条分支的 Token 都将被批量接受,从而在代码补全、格式化 JSON 结构化输出等具有高度确定性模式的场景中,将接受率提升至 80%~90% 以上。
工业级 TypeScript 模拟器:推测解码接受率评估与拒绝采样验证引擎
为帮助企业研发团队直观理解推测解码的接受/拒绝判断状态机、Token 序列重构过程以及加速比测算逻辑,以下给出一个遵循纯函数规范、具备完备异常处理与中文注释的工程级 TypeScript 模拟引擎。
/**
 * 模块:企业私有化大模型推测解码(Speculative Decoding)模拟器
 * 核心功能:模拟草稿模型生成、主模型单步并行核验、拒绝采样(Rejection Sampling)概率对齐与加速比推演
 */

// 概率分布映射字典:Token ID -> 概率值
export type ProbabilityDistribution = Record<number, number>;

// 单步草稿推测结果
export interface DraftCandidate {
  tokenId: number;
  tokenText: string;
  draftProbability: number;
}

// 主模型并行核验的单步结果
export interface TargetStepVerification {
  position: number;
  distribution: ProbabilityDistribution;
  argmaxTokenId: number;
}

// 模拟验证结果报告
export interface SpeculativeDecodingRoundReport {
  roundIndex: number;
  draftTokens: DraftCandidate[];
  acceptedCount: number;
  acceptedTokens: Array<{ tokenId: number; tokenText: string }>;
  rejectionHappened: boolean;
  rejectedIndex: number | null;
  correctedToken: { tokenId: number; tokenText: string } | null;
  finalEmittedTokens: Array<{ tokenId: number; tokenText: string }>;
  effectiveSpeedup: number;
}

/**
 * 推测解码采样器与调度管理类
 */
export class SpeculativeDecodingEngine {
  private vocabMap: Record<number, string>;

  constructor(vocabMap: Record<number, string>) {
    this.vocabMap = vocabMap;
  }

  /**
   * 执行单个推测解码轮次的拒绝采样(Rejection Sampling)判定
   * @param draftTokens 草稿模型生成的 K 个候选 Token
   * @param targetDistributions 主模型单步并行前向给出的 K+1 个位置的概率分布
   * @param temperature 采样温度系数(0 为确定性贪心模式)
   * @param randomSeedFn 可选的随机数发生函数,用于单元测试确定性复现
   */
  public executeSpeculativeRound(
    draftTokens: DraftCandidate[],
    targetDistributions: TargetStepVerification[],
    temperature: number = 0.7,
    randomSeedFn: () => number = Math.random
  ): SpeculativeDecodingRoundReport {
    const k = draftTokens.length;
    if (targetDistributions.length < k + 1) {
      throw new Error(`主模型前向分布长度不足:需要 ${k + 1} 步,实际仅传入 ${targetDistributions.length} 步`);
    }

    const acceptedTokens: Array<{ tokenId: number; tokenText: string }> = [];
    let rejectionHappened = false;
    let rejectedIndex: number | null = null;
    let correctedToken: { tokenId: number; tokenText: string } | null = null;

    // 逐位置进行推测核验
    for (let i = 0; i < k; i++) {
      const draft = draftTokens[i];
      const targetVerify = targetDistributions[i];
      const pDist = targetVerify.distribution;

      const pVal = pDist[draft.tokenId] || 0.0;
      const qVal = draft.draftProbability;

      if (temperature === 0) {
        // 贪心确定性场景判定
        if (draft.tokenId === targetVerify.argmaxTokenId) {
          acceptedTokens.push({ tokenId: draft.tokenId, tokenText: draft.tokenText });
        } else {
          rejectionHappened = true;
          rejectedIndex = i;
          // 修正为大模型贪心最高概率的 Token
          correctedToken = {
            tokenId: targetVerify.argmaxTokenId,
            tokenText: this.vocabMap[targetVerify.argmaxTokenId] || `[Token_${targetVerify.argmaxTokenId}]`
          };
          break;
        }
      } else {
        // 随机采样模式下的拒绝采样(Rejection Sampling)
        const acceptanceRatio = qVal > 0 ? Math.min(1.0, pVal / qVal) : 0.0;
        const diceRoll = randomSeedFn();

        if (diceRoll < acceptanceRatio) {
          // 概率接受
          acceptedTokens.push({ tokenId: draft.tokenId, tokenText: draft.tokenText });
        } else {
          // 触发拒绝,从残差分布 p'(x) = max(0, p(x) - q(x)) 中重新采样
          rejectionHappened = true;
          rejectedIndex = i;
          correctedToken = this.sampleFromResidualDistribution(pDist, draftTokens[i], randomSeedFn);
          break;
        }
      }
    }

    // 构建最终输出序列
    const finalEmittedTokens: Array<{ tokenId: number; tokenText: string }> = [...acceptedTokens];

    if (rejectionHappened && correctedToken) {
      // 若发生了拒绝,追加修正后的 Token,丢弃其后所有候选
      finalEmittedTokens.push(correctedToken);
    } else {
      // 若草稿 K 个全被接受,免费获得大模型第 K+1 步的前向预测 Token(无需额外前向)
      const bonusVerify = targetDistributions[k];
      const bonusTokenId = bonusVerify.argmaxTokenId;
      finalEmittedTokens.push({
        tokenId: bonusTokenId,
        tokenText: this.vocabMap[bonusTokenId] || `[Token_${bonusTokenId}]`
      });
    }

    // 计算本轮等效单次前向输出比(加速比衡量指标)
    const effectiveSpeedup = finalEmittedTokens.length;

    return {
      roundIndex: 1,
      draftTokens,
      acceptedCount: acceptedTokens.length,
      acceptedTokens,
      rejectionHappened,
      rejectedIndex,
      correctedToken,
      finalEmittedTokens,
      effectiveSpeedup
    };
  }

  /**
   * 从残差归一化分布中执行安全采样
   */
  private sampleFromResidualDistribution(
    pDist: ProbabilityDistribution,
    draftCandidate: DraftCandidate,
    randomSeedFn: () => number
  ): { tokenId: number; tokenText: string } {
    const residual: Record<number, number> = {};
    let totalResidual = 0;

    for (const [idStr, p] of Object.entries(pDist)) {
      const id = Number(idStr);
      const q = id === draftCandidate.tokenId ? draftCandidate.draftProbability : 0;
      const diff = Math.max(0, p - q);
      residual[id] = diff;
      totalResidual += diff;
    }

    // 极端边界防空降级
    if (totalResidual <= 0) {
      return {
        tokenId: draftCandidate.tokenId,
        tokenText: draftCandidate.tokenText
      };
    }

    // 累积概率切片采样
    const randThreshold = randomSeedFn() * totalResidual;
    let accumulated = 0;
    for (const [idStr, diff] of Object.entries(residual)) {
      accumulated += diff;
      if (accumulated >= randThreshold) {
        const selectedId = Number(idStr);
        return {
          tokenId: selectedId,
          tokenText: this.vocabMap[selectedId] || `[Token_${selectedId}]`
        };
      }
    }

    // 兜底返回主键
    const fallbackId = Number(Object.keys(pDist)[0]);
    return {
      tokenId: fallbackId,
      tokenText: this.vocabMap[fallbackId] || `[Token_${fallbackId}]`
    };
  }
}
企业私有化算力环境选型矩阵与智能体场景落地实战
推测解码技术虽然在理论上能提供成倍的性能跃迁,但在企业私有化部署工程中绝非“无脑开启”即可获益。如果草稿模型选型不当、推测步长 K 盲目设置过大,反而可能因为草稿生成耗时累积与显存频繁回滚,导致端到端吞吐负优化(Slowdown)。结合百信企业智能体平台的算力工程实践,建议按如下维度进行严格的选型与调优:
1. 理论加速比与临界接受率公式
推测解码的实际端到端加速比 S 可通过如下经验公式推导:
式中:α 为平均接受率(Acceptance Rate);K 为推测步长;γ 为草稿模型自回归单步耗时与主模型单步前向耗时之比(通常要求 γ <= 0.05)。
| 业务场景类型 | 文本生成特征 | 实测平均接受率 α | 建议推测步长 K | 预期加速比收益 | 工程建议与避坑要点 |
|---|---|---|---|---|---|
| 代码生成与 SQL 编写 | 强结构化、关键词(SELECT, WHERE, JOIN)与变量名高度重复确定。 | 75% ~ 88% | 5 ~ 6 | 2.4x ~ 3.1x | 极力推荐开启。在 Agent 自动生成复杂数据提取代码时效果极其显著。 |
| 智能体工具调用 (Tool Calling) | JSON 结构模板固定,字段名固定,仅参数值动态变化。 | 70% ~ 82% | 4 ~ 5 | 2.1x ~ 2.6x | 可与 Schema 语法树约束结合,首 Token 后的 JSON 参数流式输出几乎无感知卡顿。 |
| 长思维链推理 (Chain-of-Thought) | 中间逻辑推导词密集,存在逻辑跳跃与高不确定性。 | 55% ~ 68% | 3 ~ 4 | 1.6x ~ 2.0x | 步长不宜设大,否则在关键推理断点频繁回滚,造成草稿计算空转浪费。 |
| 开放式创意文案与文学撰写 | 采样温度较高(T >= 0.9),Token 分布离散度大,词汇多样性高。 | 30% ~ 45% | 1 ~ 2 (或关闭) | 0.95x ~ 1.2x | 加速收益微弱甚至可能略有降级,建议在路由网关针对此类请求动态关闭推测解码。 |
2. 企业私有化部署落地指南
- 同源模型家族严格对齐:必须确保 Draft Model 与 Target Model 共享完全相同的词表和 Special Tokens。例如 Qwen2.5-72B-Instruct 搭配 Qwen2.5-0.5B-Instruct/1.5B-Instruct,或者 Llama-3-70B 搭配 Llama-3-8B。严禁跨模型家族强行混配。
- 高并发下的显存与算力权衡:推测解码最适用于批大小较小(Batch Size 较小,如 1~8)、追求极致单流交互低延迟的在线客服与调度助手场景;在面向非实时后台批处理的大规模离线批量任务中,建议切换为连续批处理(Continuous Batching)配合大 Batch Size,利用计算饱和度换取系统总吞吐。
- 生产监控三大黄金指标:在企业私有化大模型运维监控大盘(Prometheus / Grafana)中,必须实时采集以下三项核心指标:
- Speculative Acceptance Rate (α):必须稳定在 65% 以上,跌破 50% 需发出降级告警;
- Inter-Token Latency (ITL):度量流式输出时每两个字符之间的物理间隔时间;
- Target Model Forward Bubble:度量主模型在等待草稿模型推测时的空闲时间占比。
综上所述,推测解码技术通过巧妙的“以算力换显存带宽”机制,在不折损一丝一毫输出精度的前提下,为企业私有化大模型智能体打破了物理显存带宽的沉重枷锁。结合企业级连续批处理显存管理与动态模型路由,私有化智能体平台能够在有限的硬件预算内,真正实现兼具大模型卓越智能深度与毫秒级交互流式响应的高效协同系统。