企业私有化 AI Agent 推理引擎并发优化:PagedAttention 显存分页与连续批处理(Continuous Batching)实战
针对企业私有化部署大模型智能体时面临的算力卡显存碎片化严重、静态批处理引发首字延迟(TTFT)激增、多 Agent 协作并发吞吐受限等生产痛点,系统解析虚拟内存分页技术 PagedAttention 的核心机理,深入探讨连续批处理(Continuous Batching / Dynamic Iteration-level Scheduling)的迭代级调度流水线、Chunked Prefill 预填充平滑机制以及私有化服务器环境下的算力压测与工程选型矩阵。
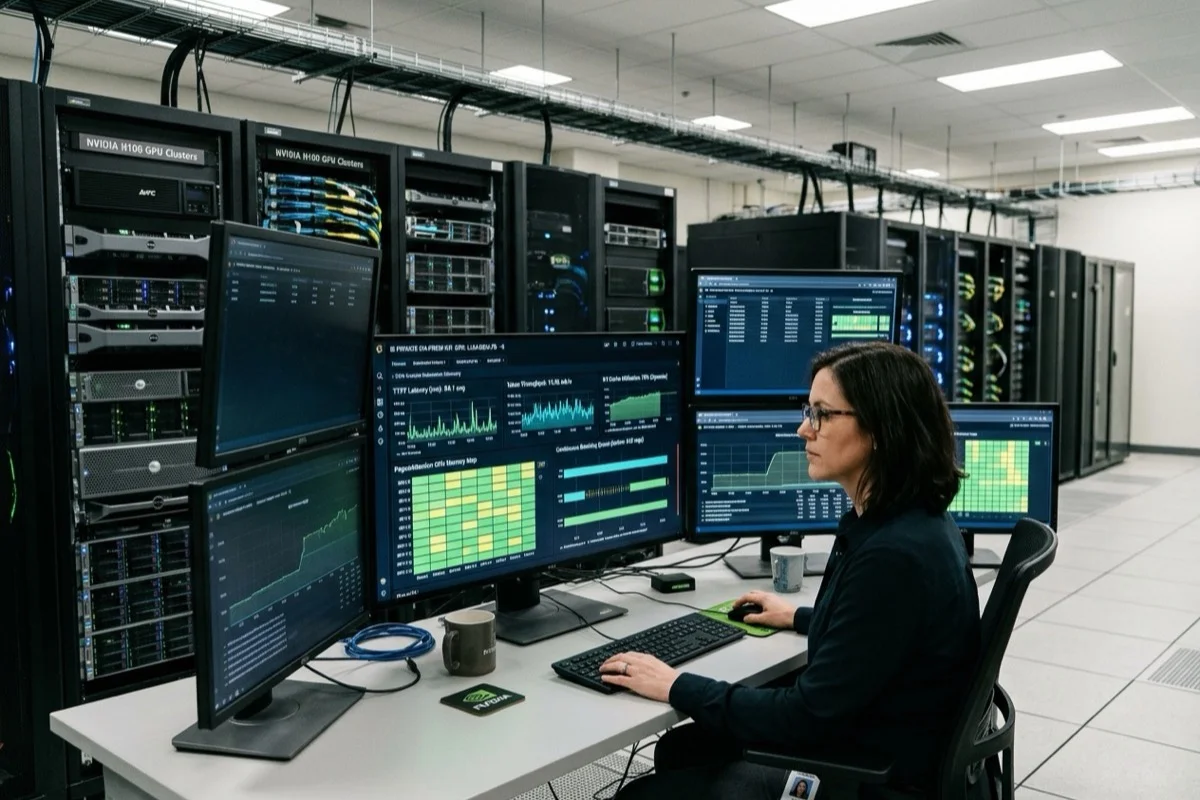
随着大模型技术在企业私有化业务场景中的纵深落地,AI Agent 的部署模式已从最初的“单用户问答测试”全面升级为多智能体协同、知识库深度检索与业务系统高频自动化调用。在这种高并发、高动态的工业级生产环境中,推理系统的并发吞吐量(Tokens per Second)与首字延迟(Time-to-First-Token, TTFT)直接决定了硬件采购投资回报比与最终业务采用率。然而,许多企业在本地数据中心部署开源大模型(如 8×A100/H800 或国产算力集群)时,常常面临令人费解的困境:GPU 显存往往在并发仅达到十几个并发连接时便发出 OOM(Out Of Memory)警报,而算力核心利用率(Compute Utilization)却往往徘徊在 30% 以下。深入底层剖析可知,这一瓶颈的核心根源在于传统深度学习静态批处理(Static Batching)与线性连续 KV Cache 内存预分配所引发的高达 60%~80% 的显存碎片化与计算“气泡”(Bubbles)。本文结合百信企业智能体平台在私有化高性能算力服务架构中的调优实践,系统拆解 PagedAttention 虚拟内存分页、连续批处理(Continuous Batching / Iteration-level Scheduling)以及分块预填充(Chunked Prefill)的核心机理、工程边界与落地配置选型,并提供可直接执行的 TypeScript 调度引擎实战实现。
传统静态批处理与显存黑洞:为什么私有化大模型并发遭遇“显存瓶颈”
在传统的深度学习模型(如 CNN 或早期 Transformer 分类模型)推理中,静态批处理(Static Batching)是提升 GPU 吞吐的标准范式:将多个输入样本拼装为一个维度固定的张量(Tensor,例如 [BatchSize, MaxSeqLen, Dim]),一次性送入矩阵乘法单元计算。然而,生成式自回归大模型(Autoregressive LLM)具有两个颠覆传统批处理假设的核心特征:输入输出长度高度不确定以及逐 Token 生成的自回归依赖。
| 显存浪费与瓶颈类型 | 底层发生机理 | 对企业智能体服务的负面影响 | 典型浪费占比 |
|---|---|---|---|
| 填充填充气泡(Padding Bubbles) | 一个 Batch 内部所有请求必须对齐到该 Batch 最长序列。短请求生成的补齐 Token(<pad>)纯属无意义的算力与显存空耗。 | 吞吐量骤降。一个长达 4000 Token 的 RAG 知识检索请求会严重拖慢同批次仅需 100 Token 的快速指令交互。 | 20% ~ 40% 算力气泡 |
| KV Cache 预分配碎片(Internal Fragmentation) | 由于无法提前预知模型到底会生成多少 Token,传统引擎必须在请求开始时,按系统最大上下文长度(如 4K 或 8K)连续预分配全量 KV 显存空间。 | “虚假 OOM”。请求实际只生成了 150 Token 便遇到了 <eos>,剩余预留的 7850 Token 显存空间完全闲置却无法被其他请求借用。 | 40% ~ 60% 显存空置 |
| 物理连续内存外部碎片(External Fragmentation) | 传统 Attention 计算算子(如标准 PyTorch 实现)要求张量在物理显存上必须严格地址连续,频繁的申请与释放导致显存碎片化。 | 尽管整体空闲显存总量充足,但由于找不到一段足够长的连续物理内存块,新请求直接触发 OOM 拒绝服务。 | 10% ~ 25% 显存不可用 |
| 早退等待等待锁死(Early-exit Idling) | 在批次级别调度中,先生成结束的请求无法提前将结果返回给客户端并释放显存,必须死等整批中耗时最长的那一个请求完成。 | 首字延迟与端到端响应延迟极度劣化,高并发下请求排队队列出现雪崩堆积。 | P95/P99 延迟劣化 2~5 倍 |
由此可见,在大模型私有化部署中,显存并非真正被有用的业务数据填满,而是被死板的静态预分配、连续性物理约束和填充补齐所吞噬。突破这一算力枷锁的关键,在于从根本上重构注意力机制的内存管理底层逻辑与批处理调度架构。
PagedAttention 核心机理:借鉴操作系统虚拟内存分页的显存革命
2023 年由加州大学伯克利分校(UC Berkeley)团队提出的 PagedAttention 算法(后演化为知名推理框架 vLLM 的核心技术),其核心哲学是将现代操作系统经典的虚拟内存分页(Virtual Memory Paging)机制引入大模型 KV Cache 显存管理。
1. 逻辑块(Logical Blocks)与物理块(Physical Blocks)的映射解耦
在 PagedAttention 架构下,每个请求的序列 KV Cache 在逻辑上表现为连续增长的 Token 序列,但在底层显存管理上被切分为固定大小的块(Block),每个 Block 包含固定数量的 Token(通常称为 block_size,如 16 或 32 个 Token)。
- 逻辑块(Logical Block):按自然序列切分,例如一个 48 Token 的序列对应
Logical Block 0 (Token 0~15)、Logical Block 1 (Token 16~31)、Logical Block 2 (Token 32~47); - 物理块(Physical Block):在 GPU 预留显存池中按固定大小切片预先初始化的物理内存页,其在显存中的地址完全不要求连续;
- 块表(Block Table):系统为每个活动请求维护一个类似于操作系统页表(Page Table)的映射目录,记录该请求的每个 Logical Block 对应到底存放在哪个具体的 Physical Block 物理插槽中。
| 对比维度 | 传统连续显存预分配机制 | PagedAttention 分页显存池机制 | 架构收益与工程评价 |
|---|---|---|---|
| 显存分配时机 | 请求到达时一次性预分配 MaxSeqLen 全量显存 | 按需动态分配(On-Demand)。只有当前 Block 填满时才申请新 Block | 彻底杜绝未生成 Token 的显存虚占 |
| 物理连续性要求 | 强依赖物理地址严格连续 | 完全不要求物理连续,通过 Block Table 间接寻址 | 消除外部内存碎片,显存利用率达 96%+ |
| 内存碎片率 | 高达 60% ~ 80% | 降至 4% 以下(仅限于序列末尾未填满的半个 Block) | 相同显存硬件下并发承载能力提升 2~4 倍 |
| 内存共享与分支 | 无法共享,相同 Prompt 必须重复全量拷贝张量 | 支持写时复制(Copy-on-Write)与多分支共享 Block | 多轮会话 System Prompt 与 Beam Search 显存复用 |
2. 块内核(PagedAttention Kernel)的高性能并行计算
在计算阶段,由于物理块散布在显存各处,标准 Torch 的密集张量矩阵乘法无法直接使用。PagedAttention 专门开发了定制化的 GPU Triton/CUDA Kernel。在自注意力计算中,GPU 线程块首先读取该请求的 Block Table,根据逻辑索引动态计算出对应的物理块显存指针,在片上共享内存(Shared Memory)中分块完成 Q × K^T 矩阵运算与 Softmax 归约,实现了在完全零显存拷贝搬运前提下的非连续物理地址注意力运算。
连续批处理(Continuous Batching)与迭代级调度(Iteration-level Scheduling)
解决了显存的非连续动态分配之后,传统的批处理调度范式也随之发生根本性跃迁:从以“请求”为调度单元的粗粒度调度,演进为以“迭代(Iteration)”为调度单元的连续批处理(Continuous Batching / Dynamic Iteration-level Scheduling)。
1. 静态批处理(Request-level) vs. 连续批处理(Iteration-level)
在传统的 Request-level 调度中,GPU 必须等待当前批次的所有请求全部生成完毕,才能开启下一个批次的处理。而在连续批处理模型中:
- 单次迭代粒度调度:推理引擎的主事件循环以单次 Token 生成迭代(1 个 Step)为基本单位进行调度;
- 随时动态入队(Dynamic Insertion):任何新到达的请求,只要显存池中有足够的物理空闲块,就可以在下一个迭代步立即插入到当前正在执行的批次中开始 Prefill 或解码;
- 即刻离队释放(Early Eviction & Release):任何请求一旦生成结束标记符(
<eos>)或达到自身的最大限制,其在当前迭代步立即被移出运行批次,其占用的物理块立即回收到全局空闲块池中,供后续请求无缝复用; - 零气泡吞吐:由于各请求在每次迭代中独立前进,彻底消除了由于请求长度不一导致的无意义
<pad>填充气泡,GPU 矩阵乘法单元始终保持近乎满负荷饱和计算。
预填充与解码解耦:Chunked Prefill 如何平滑长上下文对吞吐的冲击
在企业大模型智能体真实应用(尤其是结合知识库 RAG 与长系统提示词场景)中,连续批处理面临着一个更加棘手的工程挑战:计算密集型的预填充阶段(Prefill Phase)与内存带宽受限的解码阶段(Decode Phase)之间的天然性能冲突。
| 执行阶段 | 计算特征与主要瓶颈 | 单步耗时表现 | 并发混合时的互相干扰表现 |
|---|---|---|---|
| 预填充阶段(Prefill / Prompt Processing) | 计算密集型(Compute-bound)。一次性处理用户输入的所有 Prompt Token(如 4000 Token),高度契合 Tensor Core GEMM 大矩阵吞吐。 | 耗时长(单步可能耗费 100ms ~ 500ms) | 当一个超长 RAG 提示词进入队列时,若整批一起执行 Prefill,会直接“霸占” GPU 算力数百毫秒,导致其他正在流式打字输出的会话出现明显卡顿。 |
| 自回归解码阶段(Decode / Token Generation) | 显存带宽密集型(Memory-bandwidth-bound)。每个请求每步仅输入 1 个 Token,但需要从 HBM 显存完整加载整个模型的几十 GB 权重参数。 | 耗时短(单步仅需 15ms ~ 30ms) | 解码阶段极其敏感,需要极低且稳定的 Token 间隔时间(Inter-token Latency, ITL)。频繁被长 Prefill 打断会导致输出严重抖动。 |
为了解决长 Prompt 对流式输出延迟的剧烈冲击,现代企业级推理架构普遍引入了 Chunked Prefill(分块预填充)机制:系统将一个长达数千 Token 的 Prompt 拆分成多个固定大小的切片(例如每次只计算 512 个 Token)。在每一次调度迭代中,调度器将这 512 个 Prefill Token 与当前批次中所有的 Decode 请求合并为一个混合批次(Mixed Batch)。通过精细控制每步的总 Token 预算(max_num_batched_tokens),既利用 Prefill 的大算力吃满了 Tensor Core 的利用率,又彻底避免了解码阶段请求的饥饿排队,将私有化智能体服务的 P99 首字与流式间隔抖动压制在极致平稳的区间。
工业级 TypeScript 实现:连续批处理调度器与 Paged Block 管理模拟器
为了直观展现 PagedAttention 显存物理块分配与连续批处理调度器的运转逻辑,以下提供一套符合企业级规范的高保真 TypeScript 调度引擎实现,完整模拟了物理块池、逻辑块映射、动态请求插入、即刻释放与迭代步进计算:
/**
 * 企业级大模型推理引擎 PagedAttention 显存物理块管理器与连续批处理调度器
 * 模拟实现非连续物理显存分配、逻辑块表(Block Table)维护与迭代级(Iteration-level)动态调度
 */

/** 物理显存块接口定义 */
export interface PhysicalBlock {
  /** 物理块全局唯一标识符 */
  blockId: number;
  /** 引用计数(用于 Copy-on-Write 与多分支共享) */
  refCount: number;
  /** 当前物理块实际已存放的 Token 数量 */
  tokenCount: number;
}

/** 智能体推理请求状态枚举 */
export type RequestPhase = 'WAITING' | 'RUNNING' | 'FINISHED';

/** 推理请求上下文接口 */
export interface InferenceRequest {
  /** 业务唯一请求标识符 */
  requestId: string;
  /** 输入 Prompt 文本 */
  prompt: string;
  /** 输入已编码的 Token 序列 */
  promptTokens: number[];
  /** 已生成的输出 Token 序列 */
  outputTokens: number[];
  /** 用户设定的最大生成 Token 上限 */
  maxTokens: number;
  /** 当前运行阶段 */
  phase: RequestPhase;
  /** 属于该请求的逻辑块到物理块映射表(Block Table) */
  blockTable: number[];
  /** 请求进入队列的时间戳 */
  arrivedAt: number;
  /** 首字生成耗时(TTFT,毫秒) */
  ttftMs?: number;
}

/** 调度器核心配置选项 */
export interface SchedulerOptions {
  /** 每个 Block 容纳的 Token 数量(建议 16 或 32) */
  blockSize: number;
  /** GPU 预留显存池中可用的物理 Block 总数 */
  totalPhysicalBlocks: number;
  /** 单次迭代最大允许并发运行的序列数量 */
  maxNumSeqs: number;
}

/**
 * PagedAttention 物理显存块管理器(Block Manager)
 */
export class PhysicalBlockManager {
  private blockSize: number;
  private freeBlocks: PhysicalBlock[] = [];
  private allocatedBlocks: Map<number, PhysicalBlock> = new Map();

  constructor(totalBlocks: number, blockSize: number) {
    this.blockSize = blockSize;
    for (let i = 0; i < totalBlocks; i++) {
      this.freeBlocks.push({ blockId: i, refCount: 0, tokenCount: 0 });
    }
  }

  /** 获取当前剩余空闲物理块数量 */
  public getFreeBlockCount(): number {
    return this.freeBlocks.length;
  }

  /** 分配一个空闲物理块 */
  public allocateBlock(): PhysicalBlock {
    const block = this.freeBlocks.pop();
    if (!block) {
      throw new Error('GPU 显存物理块已耗尽(Out of Memory)');
    }
    block.refCount = 1;
    block.tokenCount = 0;
    this.allocatedBlocks.set(block.blockId, block);
    return block;
  }

  /** 释放并回收物理块 */
  public freeBlock(blockId: number): void {
    const block = this.allocatedBlocks.get(blockId);
    if (!block) return;

    block.refCount -= 1;
    if (block.refCount <= 0) {
      block.refCount = 0;
      block.tokenCount = 0;
      this.allocatedBlocks.delete(blockId);
      this.freeBlocks.push(block);
    }
  }

  /** 为指定请求追加一个 Token 并动态分配或扩展物理块 */
  public appendToken(request: InferenceRequest): void {
    const totalTokens = request.promptTokens.length + request.outputTokens.length;
    const neededBlocks = Math.ceil(totalTokens / this.blockSize);

    // 如果当前块表中拥有的物理块不足以容纳新增 Token,则动态申请新块
    if (request.blockTable.length < neededBlocks) {
      const newBlock = this.allocateBlock();
      request.blockTable.push(newBlock.blockId);
    }

    // 更新最新物理块中的 Token 计数
    const lastBlockId = request.blockTable[request.blockTable.length - 1];
    const lastBlock = this.allocatedBlocks.get(lastBlockId);
    if (lastBlock) {
      const currentInBlock = totalTokens % this.blockSize;
      lastBlock.tokenCount = currentInBlock === 0 ? this.blockSize : currentInBlock;
    }
  }

  /** 请求完成时释放其占用的全部物理块 */
  public freeRequest(request: InferenceRequest): void {
    for (const blockId of request.blockTable) {
      this.freeBlock(blockId);
    }
    request.blockTable = [];
  }
}

/**
 * 连续批处理迭代级调度引擎(Continuous Batching Scheduler)
 */
export class ContinuousBatchingEngine {
  private blockManager: PhysicalBlockManager;
  private maxNumSeqs: number;
  private blockSize: number;

  /** 等待队列 */
  private waitingQueue: InferenceRequest[] = [];
  /** 当前迭代正在执行的批次队列 */
  private runningBatch: InferenceRequest[] = [];
  /** 已完成的历史请求 */
  private completedRequests: InferenceRequest[] = [];

  constructor(options: SchedulerOptions) {
    this.blockSize = options.blockSize;
    this.maxNumSeqs = options.maxNumSeqs;
    this.blockManager = new PhysicalBlockManager(options.totalPhysicalBlocks, options.blockSize);
  }

  /** 提交新的智能体推理任务 */
  public submitRequest(requestId: string, prompt: string, promptTokens: number[], maxTokens: number = 64): void {
    const req: InferenceRequest = {
      requestId,
      prompt,
      promptTokens,
      outputTokens: [],
      maxTokens,
      phase: 'WAITING',
      blockTable: [],
      arrivedAt: Date.now()
    };
    this.waitingQueue.push(req);
  }

  /**
   * 执行单个迭代步(Iteration Step)
   * 返回当前迭代的批处理执行状态指标
   */
  public step(currentIteration: number): {
    runningCount: number;
    waitingCount: number;
    freeBlocks: number;
    newlyFinished: string[];
  } {
    // 阶段一:动态准入(Dynamic Admission)
    // 检查是否有足够的物理块容纳等待队列中的新请求
    while (this.waitingQueue.length > 0 && this.runningBatch.length < this.maxNumSeqs) {
      const candidate = this.waitingQueue[0];
      const initialBlocksNeeded = Math.ceil(candidate.promptTokens.length / this.blockSize);

      // 预留至少额外 2 个块作为解码缓冲安全边界
      if (this.blockManager.getFreeBlockCount() >= initialBlocksNeeded + 2) {
        this.waitingQueue.shift();
        candidate.phase = 'RUNNING';

        // 初始 Prefill 分配物理块并建立块表
        for (let i = 0; i < initialBlocksNeeded; i++) {
          const block = this.blockManager.allocateBlock();
          candidate.blockTable.push(block.blockId);
        }
        this.runningBatch.push(candidate);
      } else {
        // 显存水位紧张,停止准入新请求,等待已有请求释放
        break;
      }
    }

    const newlyFinishedIds: string[] = [];
    const remainingBatch: InferenceRequest[] = [];

    // 阶段二:逐序列迭代生成与 Token 追加
    for (const req of this.runningBatch) {
      // 模拟生成 1 个新 Token(此处用随机数代指)
      const nextToken = Math.floor(Math.random() * 1000) + 1;
      req.outputTokens.push(nextToken);

      // 记录首字延迟
      if (req.outputTokens.length === 1 && !req.ttftMs) {
        req.ttftMs = Date.now() - req.arrivedAt;
      }

      // 显存物理块动态感知与自增
      this.blockManager.appendToken(req);

      // 判定终止条件:到达最大长度或命中结束标记(此处模拟 5% 概率命中 EOS)
      const isEos = Math.random() < 0.05;
      const isMaxReached = req.outputTokens.length >= req.maxTokens;

      if (isEos || isMaxReached) {
        req.phase = 'FINISHED';
        // 即刻释放占用的物理显存块!
        this.blockManager.freeRequest(req);
        newlyFinishedIds.push(req.requestId);
        this.completedRequests.push(req);
      } else {
        remainingBatch.push(req);
      }
    }

    // 更新运行中批次(已完成请求立即剔除,不产生空闲气泡)
    this.runningBatch = remainingBatch;

    return {
      runningCount: this.runningBatch.length,
      waitingCount: this.waitingQueue.length,
      freeBlocks: this.blockManager.getFreeBlockCount(),
      newlyFinished: newlyFinishedIds
    };
  }
}
企业私有化推理引擎配置矩阵与基准调优实践
在企业私有云与本地机房落地 vLLM、TGI 或 SGLang 等开源推理框架时,仅理解原理并不足以确保最优效能。合理的参数配置矩阵与系统级基准调优是避免生产环境“假死崩溃”与最大化硬件潜力的核心手柄:
| 关键启动配置参数 | 推荐配置范围 | 参数调优物理意义与边界风险 |
|---|---|---|
--gpu-memory-utilization | 0.85 ~ 0.92 | 指定模型权重加载后,剩余显存用于分配 PagedAttention 物理块池的比例。严禁设为 0.98+,否则 PyTorch 临时激活值(Activation)或 CUDA Context 扩展会瞬间引发不可恢复的底层 OOM 崩盘。 |
--block-size | 16 或 32 | 单个物理块容纳的 Token 数。较小值(16)内存碎片更小(极致利用显存);较大值(32)能获得更高的 GPU 向量化访存带宽效率,适合长文本高吞吐场景。 |
--max-num-seqs | 64 ~ 256 | 单次迭代最大允许并发的请求数上限。设得过高会在高并发冲击时导致单步迭代计算时间变长,进而劣化流式生成的平滑度与 Token 间隔延迟(ITL)。 |
--enable-chunked-prefill | true(建议开启) | 企业 RAG 与长知识检索智能体的必备选项。将大长 Prompt 细分为多个 512 Token 小片,与 Decode 混合迭代调度,彻底消除长请求导致的流式卡顿。 |
--tensor-parallel-size (TP) | 单机卡数(如 2、4 或 8) | 在 NVLink 高速互联的单机内切分模型张量。严禁跨物理机进行跨网卡 Tensor Parallel,跨机必须使用 Pipeline Parallel(流水线并行)以防千兆/万兆内网通信延迟拖跨性能。 |
通过 PagedAttention 虚拟内存分页与连续批处理调度技术的深度协同,企业可以在完全不追加昂贵 GPU 硬件预算的前提下,将私有化大模型智能体平台的并发承载力提升 200%~400%,首字响应延迟压降 50% 以上,真正实现高性价比、高稳定性与工业级可控的大模型底座支撑。