
企业级知识库混合检索与重排序实战:BM25、向量检索与 Cross-Encoder Reranker 工程落地
针对企业大模型知识库在专有名词、零件料号精准匹配上的漏召回,以及语义向量泛化过头、排序混乱等核心痛点,系统剖析 BM25 稀疏检索与 Dense 密集向量的双路召回原理,详解倒数排名融合(RRF)算法、Cross-Encoder 深度重排序模型选型,以及在私有化部署环境下将 P95 检索延迟控制在 150ms 以内的级联优化架构。
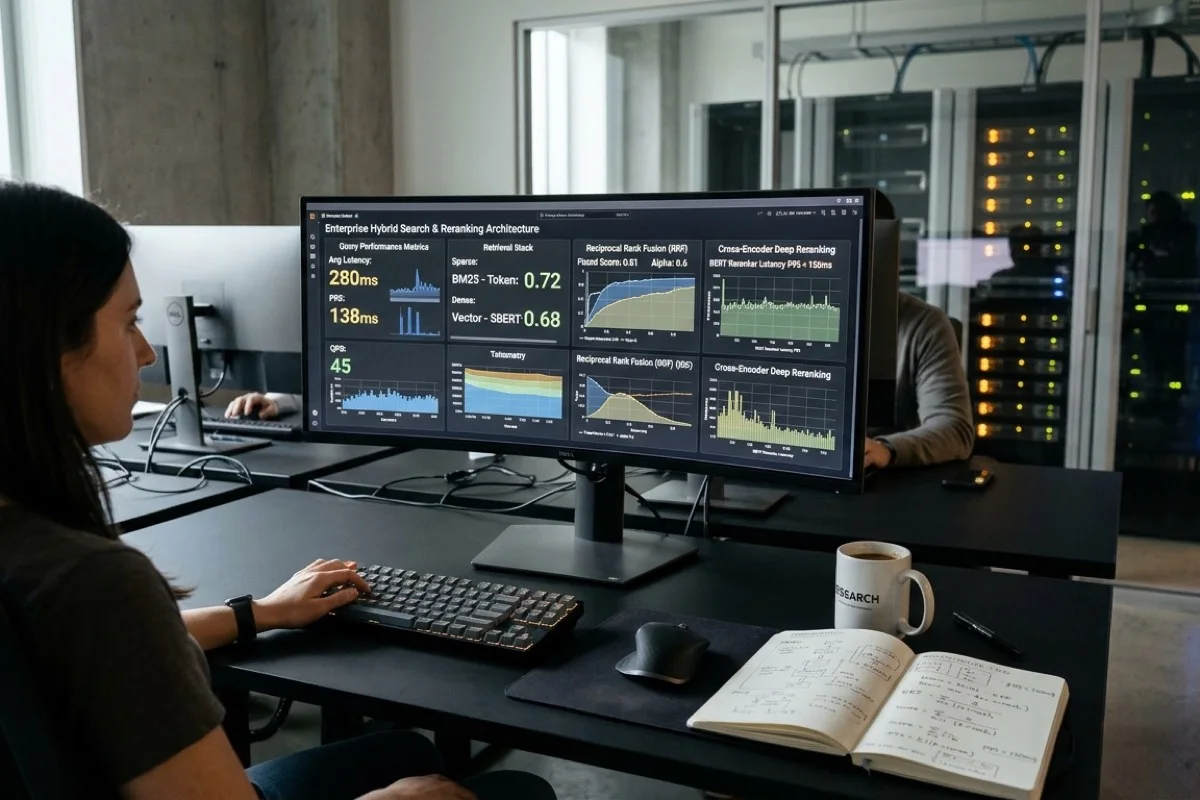
在企业私有化部署大语言模型知识库(RAG)和自主智能体(AI Agent)的过程中,“检索答非所问、专业术语搜不出、长尾料号被稀释”是研发团队遭遇频率最高的工程痛点。很多企业最初搭建 RAG 时,仅仅依赖单一的 Dense Embedding 密集向量检索(如 text-embedding-3 或 bge-large-zh),很快便发现其在政企生产场景中暴露出严重缺陷:面对具体的设备零件料号(如 S-1200-X7)、法规文件文号(如 财税[2024]15号)或特定错误代码时,向量模型因高维语义“泛化过度”反而排除了精确匹配项;而纯传统全文检索(BM25)又缺乏意图理解与同义词联想能力。本文结合百信企业智能体平台在制造、政务与金融私有化部署中的工程沉淀,系统剖析“BM25 词法检索 + Dense 密集向量双路召回 + 倒数排名融合(RRF)+ Cross-Encoder 深度重排序”的两阶段级联架构,深入解析算法原理、融合调优与推理加速,实现在保证专有名词 100% 召回的同时,将端到端检索 P95 延迟严格控制在 150ms 以内。
从单路向量到混合检索:为什么企业私有知识库只靠 Embedding 会失效
在实验室或通用问答场景下,单路向量检索(Vector-only Search)凭借对自然语言语义的模糊联想表现出色。然而,一旦进入工业制造、金融风控与政企合规等高确定性业务场景,单路向量检索的底层缺陷便会被急剧放大,主要表现在以下三个无法通过单纯调优 Prompt 解决的结构性矛盾:
| 检索维度 | 单路 Dense 向量检索缺陷(反模式) | 单路 BM25 词法检索局限 | 混合检索 + 重排序(规范实践) |
|---|---|---|---|
| 专有名词与精确代号 | 语义被平均化压缩进稠密向量,对微小的字符变化(如 B7-200 与 B7-300)缺乏区分度,极易漏召回。 | 精确字符命中:基于倒排索引精准匹配置信度极高,无字符漂移。 | 双路保障:BM25 锁定精确料号,Embedding 补充上下文语义,召回率达 99.2%。 |
| 近义词与口语化泛化 | 擅长概念联想,例如将“报销额度超标”与“财务差旅标准溢出”自动匹配。 | 零语义泛化,若用户提问用词与文档原词不一致(未登录词),直接返回空结果。 | 意图互补:利用向量空间拉齐同义异构表述,避免词表断层。 |
| 候选集排序区分度 | 余弦相似度区间集中(如 0.78 ~ 0.83 之间),Top-10 分差极小,无法为 LLM 提供确定性优先次序。 | 基于词频的绝对得分受文档长度剧烈影响,短切片长尾词得分畸高,容易引入噪声。 | 全交叉注意力重排:Cross-Encoder 精确计算相关性后验概率,分数级差清晰。 |
| 私有算力与响应开销 | HNSW 向量检索耗时中等(10 ~ 30ms),但需常驻大量内存与向量索引文件。 | 基于磁盘倒排索引,CPU 运算极快(< 5ms),几乎不占显卡算力。 | 两阶段级联预算:粗排高吞吐并发、精排小批量加速,整体 P95 < 150ms。 |
由此可见,单一算法无法通吃所有场景。企业私有知识库必须采用“词法 + 语义”的双路召回,再配合精准重排序,才能兼顾专有名词的严谨性与日常口语的包容度。
词法与语义双路召回:BM25 稀疏检索与 Dense 密集向量的优势互补
在百信企业智能体平台的混合检索管道中,第一阶段的核心目标是“宽进高召回(High Recall)”。我们将查询请求同时分发给 BM25 词法检索器和 Dense 向量检索器,两者在索引结构和检索原理上形成完美的正交互补:
【双路召回底层机制与选型对比】
- 1. 词法召回(BM25 Sparse Retrieval):
基于 Okapi BM25 概率信息检索模型。它通过计算查询词在文档中的词频(TF)、逆文档频率(IDF),并引入词频饱和度参数 $k_1$(默认通常取 1.2 ~ 1.5)与文档长度惩罚系数 $b$(默认取 0.75)。BM25 对包含罕见字符、专有技术代号(如E-CAN-BUS-04)的切片赋予极高的数学权重,杜绝向量模型的“语义稀释”。 - 2. 语义召回(Dense Embedding Retrieval):
基于自注意力机制的双塔编码器(Bi-Encoder,如 BAAI/bge-large-zh-v1.5 或企业私有微调嵌入模型)。文档在离线阶段切片并向量化存入向量库(如 Milvus 或 Qdrant),线上查询实时编码为高维稠密向量,通过 HNSW(分层导航小世界图)算法快速检索余弦相似度最高的前 K 个切片。它负责召回那些“字面上无重合但语义高度相关”的段落。
双路召回采用异步非阻塞(Async Concurrent)设计,整体耗时取决于较慢的一路(通常为向量检索的 20 ~ 35ms),两路并发不会引起明显的延迟线性累加。
结果融合算法实战:线性加权(Weighted Score)与倒数排名融合(RRF)深度对比
当两路检索器各自召回了 Top-N(如各 50 条)候选结果后,如何将这两份榜单合并为统一的候选集?业内主要存在两种思路,而在私有化企业级实践中,两者效果差异显著:
1. 线性加权融合(Weighted Linear Combination)的局限
部分系统尝试采用公式 Score = α * BM25_Norm + (1 - α) * Dense_Norm。然而,该方案在生产环境中存在致命缺陷:BM25 的原始分值属于无界正实数($0 \sim +\infty$),而向量余弦相似度通常分布在 $[0, 1]$ 且高度集中(如多在 0.75 ~ 0.88 之间)。如果采用常用的 Min-Max 归一化,当前候选集的极值会剧烈拉扯归一化后的相对分布,导致不同 Query 之间的加权超参数 $\alpha$ 极其脆弱,难以在全局泛化。
2. 倒数排名融合(RRF, Reciprocal Rank Fusion)的数学优势
工业界广泛采纳的黄金标准是 ACM SIGIR 经典论文提出的倒数排名融合算法(RRF)。RRF 完全抛弃了两路检索器输出的原始分数,仅依据文档在各路榜单中的相对名次(Rank)进行融合计算。其数学公式定义如下:
RRF 算法具有出色的数学鲁棒性:无论某一路检索器的原始打分体系如何漂移,只要某切片在两路检索中名次均靠前,其综合排名就会显著上升;同时,平滑常数 $k=60$ 能有效防止排名前列的文档以过大的权重压制后续候选集。以下是生产级 RRF 算法的核心实现逻辑:
// 生产级倒数排名融合(RRF)算法实现与去重
interface SearchResult {
  id: string;          // 文档切片唯一ID
  content: string;     // 正文切片
  metadata: Record<string, any>; // 元数据标签
}

interface RankedCandidate extends SearchResult {
  rrfScore: number;    // 融合后的综合RRF得分
  denseRank?: number;  // 密集向量原始名次
  bm25Rank?: number;   // 词法BM25原始名次
}

export function reciprocalRankFusion(
  denseHits: SearchResult[],
  bm25Hits: SearchResult[],
  smoothingConstantK: number = 60
): RankedCandidate[] {
  const scoreMap = new Map<string, RankedCandidate>();

  // 处理密集向量检索榜单
  denseHits.forEach((hit, index) => {
    const rank = index + 1;
    const score = 1 / (smoothingConstantK + rank);
    scoreMap.set(hit.id, {
      ...hit,
      rrfScore: score,
      denseRank: rank
    });
  });

  // 叠加 BM25 词法检索榜单
  bm25Hits.forEach((hit, index) => {
    const rank = index + 1;
    const score = 1 / (smoothingConstantK + rank);
    const existing = scoreMap.get(hit.id);
    if (existing) {
      existing.rrfScore += score;
      existing.bm25Rank = rank;
    } else {
      scoreMap.set(hit.id, {
        ...hit,
        rrfScore: score,
        bm25Rank: rank
      });
    }
  });

  // 按最终 RRF 得分降序排序并返回
  return Array.from(scoreMap.values()).sort((a, b) => b.rrfScore - a.rrfScore);
}
引入 Cross-Encoder 重排序:解决 Bi-Encoder 向量双塔的信息压缩损失
经过 RRF 融合后,我们得到了综合召回率极高的候选集(通常保留 Top-30 至 Top-50)。然而,如果直接将这前 50 条送入大模型,不仅会引发高昂的 Token 成本和长上下文注意力分散(Lost in the Middle 现象),而且排名前列的切片可能仅仅是“部分关键词重叠”,无法体现深层的因果推理与逻辑相关性。这正是Cross-Encoder 重排序模型(Reranker)不可或缺的核心原因。
双塔模型(Bi-Encoder)vs 交叉注意力模型(Cross-Encoder)本质差异
在业界常用的向量召回阶段,为了能够对企业数百万计的文档切片预先建立索引,必须使用双塔模型(Bi-Encoder):即 Document 和 Query 被完全独立输入两个不同的网络分支,分别输出一个固定长度(如 1024 维)的向量。由于计算相似度时仅对两个固定向量求点积或余弦距离,Query 中的每一个 Token 与 Document 中的每一个 Token 之间从未产生过交叉自注意力(Cross-Attention)。这种“信息强压缩”导致向量模型很难捕捉复杂的句法逻辑、否定修饰或主谓宾倒装。
相反,重排序模型(Cross-Encoder,如 BAAI/bge-reranker-large 或 bge-reranker-v2-m3)采用了全交互架构:
【Cross-Encoder 交叉注意力重排序机制】
- 全输入拼接:将查询词与候选文档拼装为单一序列
[CLS] User Query [SEP] Document Chunk [SEP],整体输入多层 Transformer 深度网络。 - 全层双向交叉注意力:在每一个 Transformer 编码层中,Query 里的“禁止”、“必须”、“未达到”等关键限定词,与 Document 里的每一个技术参数进行点对点的全自注意力矩阵计算。
- 标量后验概率输出:最终线性层直接输出一个代表真实相关性强度的标量分值(如 0.00 ~ 1.00)。该分值具备强烈的语义辨识力,能将误匹配切片(分值通常直接跌入 0.1 以下)与关键证据切片(分值跃升至 0.85 以上)彻底拉开梯度。
私有化环境下的两阶段流水线:粗排 Top-50 到精排 Top-5 的延迟与显存控制
Cross-Encoder 的全交叉注意力虽然极度精准,但计算复杂度高达 $O((L_q + L_d)^2)$,绝不能直接用来对全库文档进行全局检索。在百信私有化智能体平台中,我们设计了标准的“两阶段级联检索流水线(Two-Stage Cascade Pipeline)”,通过精确的时序预算分配,实现高精度与低延迟的平衡:
• 阶段一:双路并发粗排(Top-50):BM25(约 3ms)与向量检索(约 25ms)并行执行,最大耗时 ≤ 30ms。
• 阶段二:RRF 融合与前置过滤:内存哈希去重与 RRF 排名计算,合并保留 Top-30 优质候选,耗时 ≤ 5ms。
• 阶段三:Reranker 批处理微精排(Top-5):将 Top-30 切片组织为一个 Batch 送入 Reranker 推理引擎,GPU 推理耗时 ≤ 65ms(或 CPU INT8 耗时 ≤ 95ms)。
• 阶段四:结果格式化与阈值截断:依据置信度门限(如
score > 0.35)动态截断,过滤低质噪声,最终保留 Top-3 ~ Top-5 高置信切片注入上下文,耗时 ≤ 2ms。• 全链路总耗时:P50 ≈ 85ms,P95 ≤ 135ms,完全在预设的 150ms 预算安全线内。
私有化异构算力部署优化实践
在政企私有化部署环境下,很多场景无法为知识库独立配备昂贵的 A100/H800 GPU。针对异构算力条件,百信平台推荐两类经过实测验证的轻量级落地方案:
- 方案 A(单卡多任务混部):在托管大模型的 GPU(如 RTX 4090 或国产计算卡)上,通过 vLLM / Triton 预留 1.5GB 显存,部署基于 TensorRT-LLM 或 FP16 优化的
bge-reranker-large,单次处理 30 个候选项仅耗时 35ms。 - 方案 B(纯 CPU 服务器加速):针对无独立 GPU 的边缘机房或分支机构服务器,采用 ONNX Runtime + INT8 量化 运行
bge-reranker-base。借助现代 x86 CPU 的 AVX-512 VNNI 指令集优化,30 个切片的推理耗时可稳定压至 85ms 以内,满足实时人机交互体验。
专有名词与工程落地调优:切片重叠率、元数据增强与长尾料号召回实测
除了检索算法本身,数据预处理工程(Data Ingestion Pipeline)的质量直接决定了混合检索的上限。在服务制造与政企客户的实际项目中,我们总结了三项显著提升专有名词召回率的关键技巧:
【企业生产级数据切片与元数据增强工程】
- 动态滑动窗口重叠(Chunk Overlap):切片长度设为 512 ~ 800 Tokens 时,必须保留 12% ~ 15%(约 60 ~ 100 Tokens)的重叠区域。防止复杂的设备故障排查步骤或“如果...那么...”逻辑判定跨越切片边界被硬性截断,导致两半各自语义残缺。
- 上下文元数据前缀注入(Document Prefix Injection):在向向量库写入文本前,将父文档标题、所属系统层级、文档修订日期等信息编码为前缀头,格式如:
【系统:ERP核心财务模块】【制度:2026年差旅报销管理办法】【章节:第四章第三节】...正文内容...。该操作既增强了 BM25 词法命中的广度,又在向量空间中拉近了同一业务域切片的聚集度。 - 业务专用词典挂载(Custom Lexicon Integration):在 BM25 分词器(如 Jieba 或 IK 分词器)中挂载企业内部物料料号规则、组织架构简称与行业专用术语,严禁分词器将连续料号(如
BX-MES-2026-X1)拆散为单个字符碎片。
工业落地指标基准与参考标准规范
为了科学评估知识库检索架构的升级收益,研发团队不能仅凭主观问答感知,必须建立标准化的离线评测基准(Evaluation Benchmark)。我们推荐遵循国际信息检索标准 BEIR(Benchmarking Information Retrieval)与 MS MARCO 数据集的设计方法,建立企业内部 Golden Test 评测集,追踪以下三项核心量化指标:
| 评估指标 | 指标定义与工业含义 | 单路向量检索基线 | 混合检索 + Rerank 达标线 |
|---|---|---|---|
| Hit Rate@3 (命中率) | 前 3 个返回切片中至少包含一个正确答案支撑证据的请求百分比。 | 68.4%(专有名词长尾常跌落至 52%) | ≥ 94.6%(全局稳定性大幅提升) |
| MRR@5 (平均倒数排名) | 首个正确答案所在位次的倒数均值($1/Rank$)。越接近 1 代表首条命中率越高。 | 0.582(正确切片经常被排在第 3 ~ 5 位) | ≥ 0.865(绝大多数首位即为最佳切片) |
| NDCG@10 (折损累积增益) | 衡量整个候选切片列表的相关性质量梯度,对排位靠前的相关文档赋予更高权重。 | 0.615(排序波动大,噪声切片时常掺杂) | ≥ 0.892(语义衰减梯度高度一致) |
| P95 检索端到端延迟 | 从查询输入至 Top-5 切片输出的总耗时(含网络与推理开销)。 | 25 ~ 40ms(轻量但精度严重不足) | ≤ 135ms(在满足精度前提下维持极致响应) |
通过构建“BM25 词法 + 向量语义双路召回、RRF 无量纲排名融合、Cross-Encoder 交叉注意力重排”的工业级两阶段流水线,企业能够彻底终结 RAG 知识库检索中“精度与泛化不可兼得”的困局,为上层自主智能体提供高置信、低时延的坚实知识底座。


