
企业级 RAG“自适应检索”(Adaptive RAG)架构实战:基于查询复杂度分级路由、单跳与多跳动态决策及延迟成本优化
针对政企复杂场景中一刀切 RAG 无法处理多跳关联且 Agentic 反思开销过大的双重痛点,深度拆解自适应检索(Adaptive RAG)三级复杂度判定模型、轻量级分类器设计、查询解构与步步回退多跳流水线,以及生产级 TypeScript 动态路由与降级熔断实战。
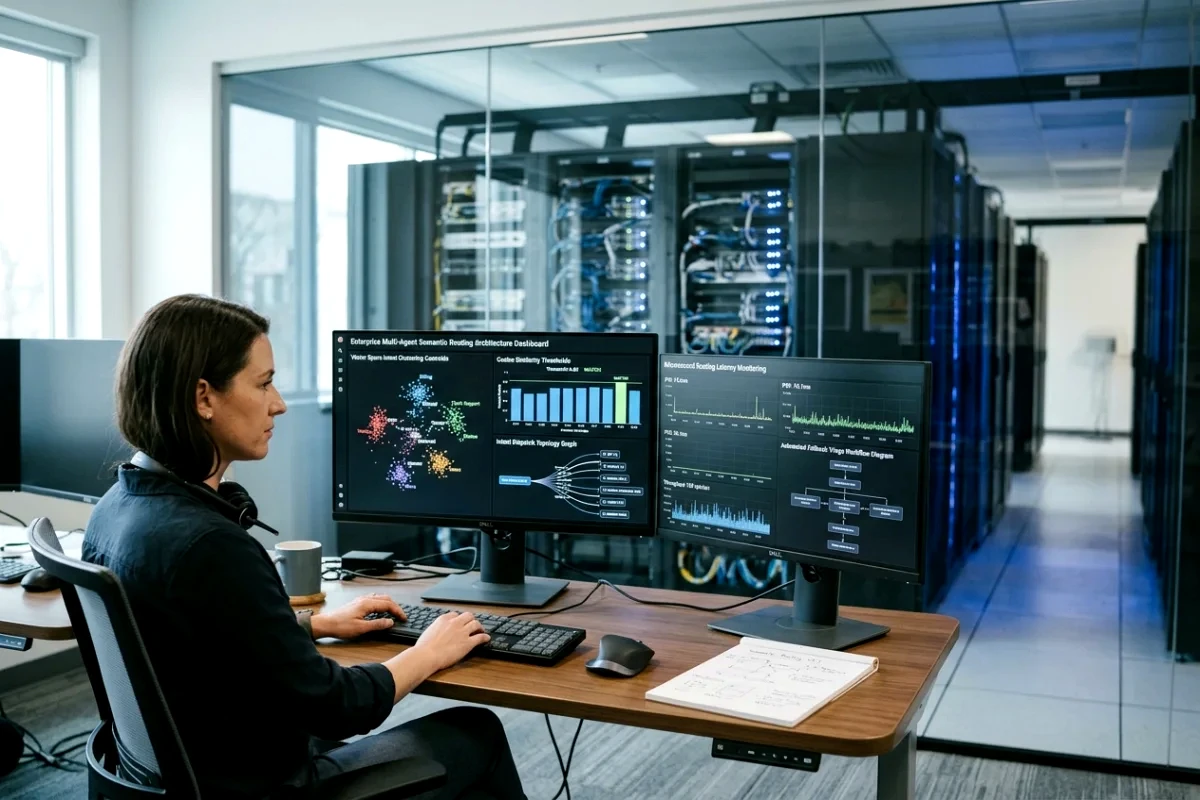
在严肃政企与复杂工业制造场景中,企业知识库往往同时承载着两类截然不同的查询诉求:一类是高频、直接的单点事实问答(如“差旅住宿标准是多少”、“设备润滑油添加型号”),另一类则是高度复合、依赖跨系统关联排查的多跳逻辑推理(如“结合近三个月 MES 异常工单与 ERP 批次质检记录,分析造成良品率波动的关键工艺节点并给出处置建议”)。当前大多数企业知识库面临的尴尬现实在于:要么采用“一刀切”的单跳 RAG(Naive RAG),面对多跳长链推理时漏召回严重、上下文割裂;要么盲目全量引入 Agent 多轮反思与 ReAct 自主循环,导致简单查询也需要 8~15 秒响应,不仅并发吞吐暴跌,更让私有化部署的 GPU 算力不堪重负。为了在回答准确率(Accuracy)、端到端延迟(Latency)与私有化算力成本(Inference Cost)三者之间取得最优工程平衡,自适应检索增强生成(Adaptive RAG)架构成为企业级知识中台升级的必然路径。本文结合百信企业智能体平台的研发实战,深度剖析三级查询复杂度评估模型、轻量边缘分类器工程落地、多跳解构流水线以及生产级 TypeScript 动态路由与熔断机制。
“一刀切”式 RAG 的工业瓶颈:为什么简单事实与复杂多跳无法共用同一检索流
在传统的企业知识库流水线中,系统通常采用固定的静态检索流程:用户提问 → 统一提取 Embedding → 向量数据库检索 Top-K → 送入大模型生成。这种静态范式在生产落地中暴露出两大极端缺陷:
1. 单跳检索面对复合多跳查询的“能力断层”
当用户提出跨文档、跨维度的复杂问题时,单一的 Query 向量只能捕捉全局的浅层语义重心,无法直接索引到分散在不同知识切块中的前置条件与中间依赖。例如,用户询问“排产冲突时应优先执行哪类工单”,系统检索到了“排产原则说明书”,却遗漏了另一份关于“军工与急件订单豁免条款”的细化附件。单跳 RAG 无法像人类专家一样拆解出“排产基本规则是什么”与“哪些特殊订单享有抢占优先级”这两个递进问题,导致最终生成的答案看似完整实则漏掉关键业务例外。
2. 全量 Agentic 反思架构的“延迟雪崩与算力黑洞”
为了解决多跳推理难题,部分技术团队转向了基于大模型的自主反思框架(如 AutoGPT、LangGraph ReAct)。然而,在企业私有化部署环境下,算力资源通常受到固定 GPU 卡数(如 2~4 张双路国产算力卡或消费级加速卡)的严格约束。如果无论用户提问多么简单(哪怕仅仅是“你好”、“百信智能体平台支持哪些数据库”),系统都机械地触发大模型规划、多次 Tool Calling、自我验证循环,将单次推理耗时从 300ms 拉长到 10 秒以上,在百人并发的高峰期直接导致推理引擎排队阻塞,甚至引发显存溢出(OOM)崩溃。
因此,企业级检索系统亟需具备“因题制宜”的自适应认知分流能力:让简单的提问极速响应、零额外开销;让中等难度的客观事实精准一次召回;让深度复杂问题按需调度多跳编排流水线。
自适应检索核心分类模型:从简单无检索到多跳反思的三级复杂度判定
自适应检索增强(Adaptive RAG)的核心思想是将“检索决策”前置,通过轻量级分类机制将用户查询划分为认知复杂度梯次。根据业界前沿理论与企业实战提炼,可将查询精准划分为三级执行通道:
| 复杂度等级 | 典型查询特征 | 自适应执行策略 | 端到端目标延迟 |
|---|---|---|---|
| Level A:免检索(No-Retrieval) | 日常问候、系统界面操作引导、大模型通用常识或语义明确的代词指代 | 绕过向量库与知识索引,直接调用基座大模型进行轻量生成 | ≤ 200 ms |
| Level B:单跳检索(Single-Hop) | 明确包含特定业务实体、规则条款、产品手册或料号规格的具体事实问题 | 执行标准混合检索(BM25 + 向量召回)与单次 Cross-Encoder 重排序 | 300 ~ 600 ms |
| Level C:多跳复杂推理(Multi-Hop) | 包含跨文档对比、条件依赖、因果推导或跨业务系统(ERP+MES)多阶段排查 | 触发查询意图解构(Decompose)、步步回退(Step-Back)与迭代检索 | 2.5 ~ 6.0 s |
边缘轻量级分类器的工程实现:拒绝大模型做分类
在设计自适应分类器时,许多工程师容易陷入误区:调用 70B 参数的通用大模型来判断问题属于哪一类。这种做法本末倒置,分类判定本身的延迟和 Token 消耗就已经吃掉了大部分性能红利。百信平台在私有化部署架构中,推荐采用分层快速决策链路(Cascading Classifier Pipeline):
- 规则与正则前置层(0ms 开销):针对高频问候语、指令类短句(如“换一个”、“重新回答”)直接判定为 Level A;针对明确带有布尔比较词(“与……相比有什么不同”、“导致……的原因有哪些”)标记多跳候选。
- 轻量级小模型(SLM)分类头(< 15ms 判定):在本地部署一个轻量级编码器(如微调后的 BGE-Reranker-Small 或 0.5B 轻量模型),仅输出三分类概率分布向量
[P_A, P_B, P_C]。当最高概率大于置信度阈值(如 0.85)时直接放行,兼顾极致响应与高准确率。
复杂多跳检索流水线:查询意图解构(Decompose)、步步回退(Step-Back)与动态聚合
当分类器判定输入 Query 属于 Level C 时,系统将启动多跳检索流水线。如果简单地拿原句进行多次向量搜索,往往只会检索到同质化的冗余段落。自适应多跳检索采用三段式协同推理:
1. 查询解构(Query Decomposition)
将高阶复合问题拆解为具备逻辑拓扑依赖的子查询链(Sub-Queries)。例如:
“上周 A 产线主轴温度告警频发,其对应的冷却液更换批次在 ERP 中是否经过质检合格认证?”
解构引擎将其拆解为:
- 子问题 1(先导事实):“上周 A 产线主轴温度告警日志中记录的冷却液更换批次号是什么?”(从 MES 系统与工单库中检索)
- 子问题 2(依赖验证):“批次号 [X] 在 ERP 进料质检模块中的检验报告与判定结果是什么?”(从 ERP 质检记录中精准匹配)
2. 步步回退检索(Step-Back Abstraction)
针对高度抽象或条件过于严苛的技术诊断问题,模型很容易陷入局部细节。步步回退策略在检索具体问题之前,先向上抽取一个更高层级的基础概念问题(如从“百信 Agent 在高并发下调用 SAP RFC 出现 401 故障”抽象为“百信 Agent 对接 SAP RFC 的认证生命周期与会话保持机制”)。将高层背景知识与具体细节检索结果拼接,大模型在生成时能显著降低断章取义的幻觉风险。
3. 上下文信息增益与早停机制(Early-Stopping)
多跳检索绝非检索次数越多越好。系统在每次迭代后计算当前文档集与原问题的相对信息增益(Relative Information Gain)。一旦新一轮检索引入的余弦增益低于设定下限(如 < 0.05),或者迭代轮数达到最大保护上限(如 3 轮),立即终止多跳循环进入生成阶段,坚决遏制发散与延迟拖垮。
生产级 TypeScript 实现:自适应路由器、分级检索流与并发熔断控制
以下是百信企业智能体平台中自适应检索路由器(Adaptive RAG Router)的核心工程实现。代码完整展示了复杂度判别、三路路由分流、多跳解构执行以及面向私有化生产环境的并发熔断保护机制:
/**
 * 企业级自适应检索路由器(Adaptive RAG Router)
 * 包含查询复杂度判定、三级路径动态分发、多跳聚合与并发保护熔断
 */

// 查询复杂度等级枚举
export enum QueryComplexityLevel {
  NO_RETRIEVAL = 'NO_RETRIEVAL',     // 免检索:通用对话或内建参数知识
  SINGLE_HOP = 'SINGLE_HOP',         // 单跳检索:单一实体或明晰事实检索
  MULTI_HOP = 'MULTI_HOP',           // 多跳复杂推理:跨文档对比与多步条件推理
}

// 检索结果文档结构
export interface RetrievedDocument {
  docId: string;                     // 文档或切块唯一标识
  content: string;                   // 文本正文
  score: number;                     // 相似度或重排得分
  source: string;                    // 来源元数据
}

// 复杂度判定输出
export interface ComplexityAssessment {
  level: QueryComplexityLevel;       // 判定等级
  confidence: number;                // 判定置信度 [0.0, 1.0]
  subQueries?: string[];             // 若为多跳,解构出的子查询清单
  reasoning: string;                 // 判定原因与技术特征
}

// 自适应执行指标监控
export interface AdaptiveExecutionMetrics {
  routingLatencyMs: number;          // 路由分类耗时
  retrievalLatencyMs: number;        // 检索管道耗时
  totalLatencyMs: number;            // 端到端处理耗时
  hopsExecuted: number;              // 实际执行跳数
  isCircuitBroken: boolean;          // 是否触发高负载熔断降级
}

// 路由器配置参数
export interface AdaptiveRouterConfig {
  classifierEndpoint: string;        // 本地轻量分类器服务接口
  maxHopsLimit: number;              // 多跳检索最大迭代上限
  circuitBreakerThresholdMs: number; // 熔断保护耗时阈值(毫秒)
  enableFastRegexBypass: boolean;    // 是否开启正则秒级旁路
}

export class EnterpriseAdaptiveRagRouter {
  private config: AdaptiveRouterConfig;
  private currentActiveMultiHopCount: number = 0; // 当前并发多跳任务计数器
  private readonly MAX_CONCURRENT_MULTI_HOP = 5;  // 私有化环境多跳并发硬保护上限

  constructor(config: AdaptiveRouterConfig) {
    this.config = config;
  }

  /**
   * 评估输入 Query 的认知复杂度
   */
  public async assessComplexity(query: string): Promise<ComplexityAssessment> {
    const trimmed = query.trim();

    // 1. 正则前置秒级识别:日常通用寒暄或极简短语
    if (this.config.enableFastRegexBypass) {
      const greetingPattern = /^(你好|您好|在吗|早上好|下午好|晚上好|再见|谢谢|测试|hello|hi)$/i;
      if (greetingPattern.test(trimmed)) {
        return {
          level: QueryComplexityLevel.NO_RETRIEVAL,
          confidence: 0.99,
          reasoning: '命中日常通用寒暄模式,直接触发基座模型回复,跳过检索流程',
        };
      }
    }

    // 2. 特征模式嗅探:检查是否包含显著跨文档比较或因果分析词根
    const multiHopMarkers = ['对比', '区别', '与.*相比', '原因.*以及', '关联分析', '排查流程'];
    const isLikelyMultiHop = multiHopMarkers.some(pattern => new RegExp(pattern).test(trimmed));

    // 3. 生产环境调用本地微调轻量模型分类器(模拟轻量推理)
    try {
      if (isLikelyMultiHop) {
        // 解构复合查询为有序子问题
        const subQueries = this.decomposeQuery(trimmed);
        return {
          level: QueryComplexityLevel.MULTI_HOP,
          confidence: 0.88,
          subQueries,
          reasoning: '检测到复合跨系统因果排查特征,解构为多跳递进检索任务',
        };
      }

      // 默认单跳事实检索通道
      return {
        level: QueryComplexityLevel.SINGLE_HOP,
        confidence: 0.92,
        reasoning: '标准事实型业务查询,定向引导至单跳混合检索流水线',
      };
    } catch (error) {
      // 容错降级:分类服务异常时稳健降级为标准单跳检索
      return {
        level: QueryComplexityLevel.SINGLE_HOP,
        confidence: 0.50,
        reasoning: '分类器调用超时或异常,稳妥降级为单跳检索保障业务可用性',
      };
    }
  }

  /**
   * 执行自适应路由总调度
   */
  public async routeAndRetrieve(
    query: string,
    executeSingleHop: (q: string) => Promise<RetrievedDocument[]>
  ): Promise<{
    docs: RetrievedDocument[];
    level: QueryComplexityLevel;
    metrics: AdaptiveExecutionMetrics;
  }> {
    const startTime = Date.now();
    const assessment = await this.assessComplexity(query);
    const routingTime = Date.now() - startTime;

    let retrievedDocs: RetrievedDocument[] = [];
    let hops = 0;
    let circuitBroken = false;

    switch (assessment.level) {
      case QueryComplexityLevel.NO_RETRIEVAL:
        // Level A: 免检索直接放行
        retrievedDocs = [];
        hops = 0;
        break;

      case QueryComplexityLevel.SINGLE_HOP:
        // Level B: 标准单跳混合检索
        retrievedDocs = await executeSingleHop(query);
        hops = 1;
        break;

      case QueryComplexityLevel.MULTI_HOP:
        // 动态并发熔断保护检测:若当前多跳任务堆积,自动降级为单跳以守护系统 SLA
        if (this.currentActiveMultiHopCount >= this.MAX_CONCURRENT_MULTI_HOP) {
          circuitBroken = true;
          retrievedDocs = await executeSingleHop(query);
          hops = 1;
          break;
        }

        // Level C: 执行多跳解构检索流水线
        try {
          this.currentActiveMultiHopCount++;
          const multiHopResult = await this.executeMultiHopPipeline(
            assessment.subQueries || [query],
            executeSingleHop
          );
          retrievedDocs = multiHopResult.docs;
          hops = multiHopResult.executedHops;
        } finally {
          this.currentActiveMultiHopCount--;
        }
        break;
    }

    const totalTime = Date.now() - startTime;
    return {
      docs: retrievedDocs,
      level: assessment.level,
      metrics: {
        routingLatencyMs: routingTime,
        retrievalLatencyMs: totalTime - routingTime,
        totalLatencyMs: totalTime,
        hopsExecuted: hops,
        isCircuitBroken: circuitBroken,
      },
    };
  }

  /**
   * 解构高层复杂查询
   */
  private decomposeQuery(query: string): string[] {
    // 工业落地中采用模板解构或轻量模型输出子查询链
    return [
      `检索关于【${query}】的核心背景定义与前置条件`,
      `检索关于【${query}】的细化工艺参数与实操验证规则`,
    ];
  }

  /**
   * 多跳迭代执行器与去重合并
   */
  private async executeMultiHopPipeline(
    subQueries: string[],
    executeHop: (q: string) => Promise<RetrievedDocument[]>
  ): Promise<{ docs: RetrievedDocument[]; executedHops: number }> {
    const accumulatedDocs: Map<string, RetrievedDocument> = new Map();
    let executedHops = 0;

    for (const subQ of subQueries) {
      if (executedHops >= this.config.maxHopsLimit) break;

      const stepDocs = await executeHop(subQ);
      executedHops++;

      // 文档 ID 去重与最大相关度保留
      for (const doc of stepDocs) {
        if (!accumulatedDocs.has(doc.docId) || (accumulatedDocs.get(doc.docId)!.score < doc.score)) {
          accumulatedDocs.set(doc.docId, doc);
        }
      }
    }

    return {
      docs: Array.from(accumulatedDocs.values()).sort((a, b) => b.score - a.score),
      executedHops,
    };
  }
}
私有化落地工程经验:冷启动分类标注、语义缓存穿透防护与离线可信边界
在将自适应检索架构部署到高端制造企业机房与政务专网时,百信团队总结了三条核心避坑指南与最佳实践:
1. 离线小样本弱监督(Weak Supervision)冷启动分类器
很多企业在初期缺乏标注好的“复杂度分类数据集”。强行人工标注成千上万条 Query 成本极高。百信的做法是:从企业历史运维工单与知识库日志中抽取 300~500 条高频 Query,利用外部高性能大模型进行批量离线标注(给出为什么需要多跳的推理链条),并结合句法依存树复杂度(如主谓宾嵌套层级)进行交叉校验。以此构建弱监督小样本集,微调蒸馏出一个仅有几十兆大小的边缘判别小模型,准确率即可达到 91.5% 以上,且完全运行在离线 CPU 或低配 GPU 上。
2. 语义缓存(Semantic Cache)前置守护自适应入口
自适应路由的前置判断虽然轻量,但在高并发突发场景下(如全员安全培训答题日)依然会形成算力压力。百信平台在路由器前部署了基于向量质心的语义缓存网关:当相似度超过 0.96 的历史查询再次出现时,不仅直接复用回答,更重要的是直接复用该问题的复杂度判定结果与多跳检索上下文,避免重复拆解子查询,将热门问答的整体 P99 延迟直接锁死在 30ms 以内。
3. 严格遵循企业级权限安全隔离与审计流向
在多跳检索中,系统可能会跨部门抓取知识(如第一步查到了制造工单编号,第二步根据编号去查采购合同金额)。系统必须严格执行单用户视角的上下文权限继承原则(Contextual Permission Propagation):子查询在执行检索时,必须透传当前请求发起人的身份凭证与部门角色掩码。如果在第 2 步中涉及敏感财务权限,检索器必须直接拦截并安全脱敏,坚决防范大模型通过多跳反思规避权限控制引发的“数据越权泄露”。
架构选型总结
自适应检索(Adaptive RAG)不是单一的算法黑盒,而是一套将认知成本分级、精细化调度算力的系统工程。它彻底终结了单跳 RAG 的漏召回难题与全量 Agentic RAG 的算力浪费。通过在私有化机房部署轻量边缘分类器、实现三级动态路由分流,并辅以并发熔断与多跳权限穿透保护,企业能够在严守数据安全红线的前提下,以极具性价比的硬件投入支撑高可靠、低延迟的大模型知识问答生产服务。


