
企业级 AI Agent 结构化输出保证实战:语法引导采样(Guided Decoding)、JSON Schema 严格约束与多层自愈架构
针对大模型在企业 ERP、MES 与工单系统自动化对接中常见的 JSON 截断、Markdown 代码块污染、枚举值幻觉与字段缺失等致命痛点,深入剖析基于上下文无关文法(CFG)与有限状态机的推理层引导采样(Guided Decoding)机制,详解应用层 Pydantic 严格模式校验与自愈纠错反馈环(Self-Healing Loop)的多层防御设计。
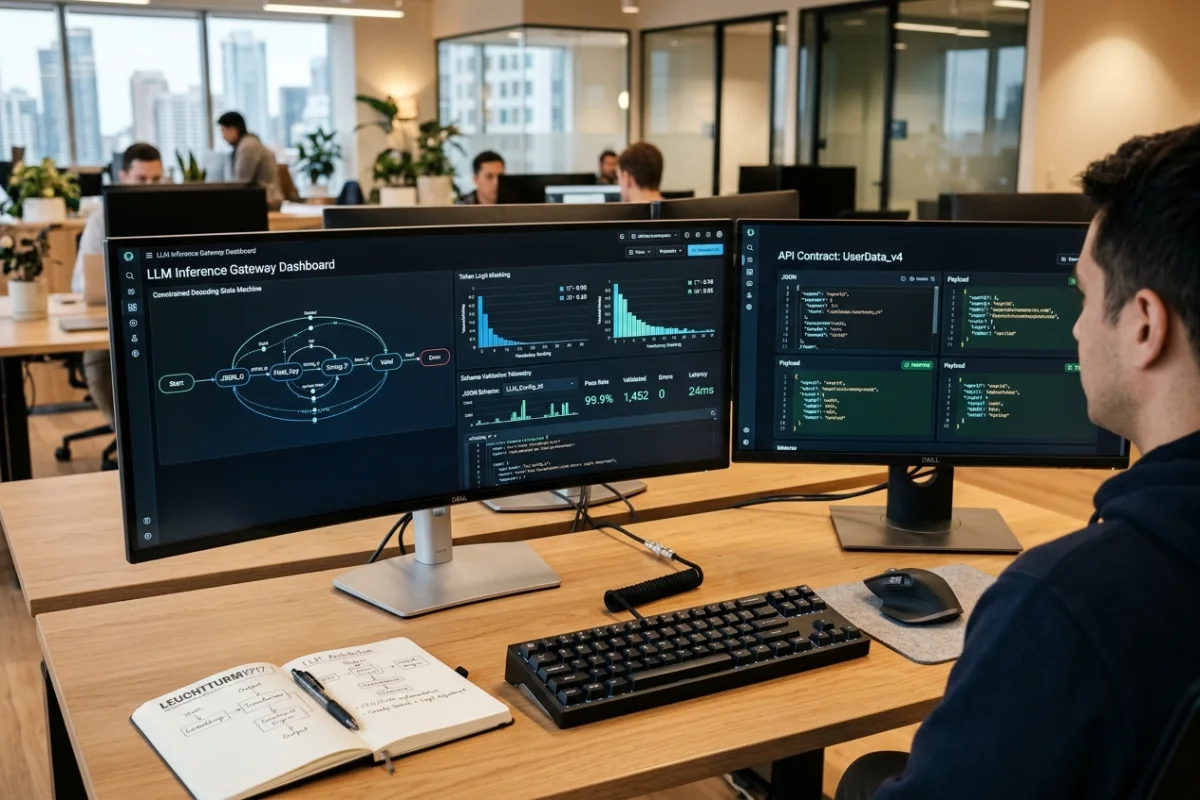
将大语言模型(LLM)从开放域的问答交互推向企业核心生产业务(如自动触发 ERP 采购单生成、MES 产线异常工单下发、财务凭证自动分录及多系统 API 编排)时,研发团队遭遇的最普遍且最致命的工程痛点,莫过于“大模型输出的非确定性与业务系统强类型契约之间的断层”。即使在提示词中反复强调“只输出合法 JSON,禁止携带任何解释说明”,模型在极端长文本、复杂嵌套或高并发推理负载下,依然会偶发输出带有 Markdown 反引号包裹、尾部字段截断、枚举类型幻觉或必填键缺失的不合格字符串,导致下游微服务解析直接崩溃。本文结合百信企业智能体平台在私有化部署环境中的核心工程实践,系统解析“底层推理引擎语法引导采样(Guided Decoding / Grammar-based Sampling)+ 应用层严格模式校验(Strict Schema Validation)+ 智能自愈纠错环(Self-Healing Loop)”的三层防御架构,彻底终结结构化数据提取的不可靠问题。
概率生成与确定性系统的断层:大模型结构化输出的四大工程陷阱
传统软件工程建立在严格的强类型契约之上(如 Protocol Buffers、OpenAPI / JSON Schema、SQL DDL),下游系统假定接收到的数据绝对符合字段类型与长度约束。而大语言模型在本质上是基于自回归概率分布预测下一个 Token 的随机采样机。在缺乏底层强制约束的环境中,仅依赖 Prompt 约定结构化输出,在企业高可用生产系统中存在以下四大典型工程陷阱:
| 失效模式 | 典型表现形态 | 系统下游直接危害 | 传统 Prompt 工程防护效果 |
|---|---|---|---|
| Markdown 语法污染与多余释义 | 在 JSON 前后输出反引号代码块标记,或在结尾擅自附加“以上是为您整理的采购清单”等自然语言解释。 | 标准的 JSON.parse() 或微服务的反序列化中间件抛出语法异常,流程直接阻断。 | 不可靠:高并发下仍有 1%~3% 的模型偏离概率,无法满足生产级 99.9% 要求。 |
| Token 窗口超限与尾部截断 | 当抽取长列表数据时达到 Token 上限,JSON 在半途中断(如缺失闭合花括号或方括号)。 | 产生半截畸形结构,无法反序列化为实体对象;若强行截断解析会导致关键明细行丢失。 | 完全无效:Prompt 无法预测输出长度与物理 Token 预算的冲突。 |
| 枚举值幻觉与语义漂移 | 业务状态字段限定为枚举白名单,模型自行输出了同义近义词或未经授权的中文描述。 | 数据库枚举字段校验失败,外键关联错误,或导致下游状态机逻辑进入未知异常分支。 | 部分缓解:Few-Shot 能降低发生率,但在冷门语义或长尾输入下依然频发。 |
| 数值与布尔类型混淆 | 金额字段要求输出浮点数,输出为带单位字符串;布尔型输出为包含引号的字符串。 | 下游强类型系统(如 Java/Go RPC)反序列化直接报错,或引发严重的资金计算精度偏差。 | 不稳定:模型在不同采样温度下类型稳定性差异极大。 |
单纯依靠在系统提示词中恐吓模型,不仅浪费宝贵的前缀上下文窗口,而且在大规模企业高频请求下根本无法提供百分之百的可用性保障。解决该问题的关键,必须下沉到大模型推理引擎的采样阶段与应用网关的校验层。
根治幻觉的底层技术:推理引擎语法引导采样(Guided Decoding)工作原理
彻底解决结构化输出格式漂移的工业级方案,是在大模型自回归解码生成每一个 Token 时,直接动态修改其词表概率分布,使得所有会导致语法错误的 Token 概率被强制置为负无穷大。这项技术被称为语法引导采样(Grammar-guided Decoding)或受限生成(Constrained Generation)。
【引导采样(Guided Decoding)的底层数学与状态转移机制】
- 1. 文法编译(Grammar Compilation):
在推理开始前,推理网关将目标 JSON Schema 或 Pydantic 模式编译为确定性有限状态自动机(DFA / FSM)或上下文无关文法(CFG)。状态机中的每一个节点代表当前 JSON 的解析位置(如处于键名等待、冒号之后、数值开始、枚举列表内等)。 - 2. 词表有效性投影(Vocabulary Indexing & Masking):
词表中的每个 Token 都对应一个字符序列。在模型预测第 t 个 Token 前,引导引擎根据状态机当前所处的合法后继状态,快速计算出当前步骤所有合法 Token 的集合 V_valid。 - 3. 实时 Logit 偏置掩码(Logits Masking):
对于模型计算出的原始 Logits 向量,引导引擎应用掩码函数:合法 Token 保留原始权重,非法 Token 强制置为负无穷。随后经过 Softmax 归一化采样,从而从数学上保证模型绝不可能选出任何破坏语法规则的 Token。 - 4. 状态自动机步进(State Transition):
一旦选定采样 Token,状态机根据该 Token 所代表的字符序列跳转至新状态,为预测下一个 Token 准备全新的掩码矩阵,直至输出终止符。
主流开源推理框架(如 vLLM、Outlines、SGLang 及 llama.cpp)均已在引擎内部高度优化了语法状态机的高效索引与并行掩码计算。通过引入针对前缀的预计算索引,语法引导采样所带来的额外延迟开销已被压缩到通常小于 5% 的微秒级水平,却换来了 100% 格式合规的确定性收益。
双层防御设计:推理引擎 Logit 掩码约束与应用层 Pydantic 严格模式协同
在企业级私有化智能体网关架构中,仅靠底层 Guided Decoding 还不能完全解决所有业务层约束。例如:Guided Decoding 能够保证输出的数值是合法的浮点数,但无法直接阻止业务层面的“单笔提款金额必须大于 0 且小于用户账户余额”等深度业务逻辑验证。因此,百信智能体平台确立了“底层推理引导保格式语法,上层 Pydantic 模式保业务语义”的双层协同规范:
| 防御分层 | 核心技术与组件 | 拦截与保证的核心目标 | 处理时机与性能开销 |
|---|---|---|---|
| 第一层:推理层物理语法约束 | vLLM Guided Decoding / XGrammar / OpenAI strict JSON Schema 采样 | 强制保证 JSON 格式有效、括号闭合、无 Markdown 标记、字段名与类型完全匹配、枚举值 100% 落在预设白名单中。 | Token 生成期间流式进行,单 Token 掩码开销微小,消除生成后的反复解析崩溃。 |
| 第二层:应用层语义与业务规则校验 | Pydantic v2 / Zod Schema / 自定义校验器 | 数值跨度边界、字符串长度与正则规范(如身份证号、统一社会信用代码)、跨字段联动守卫。 | 完整 Payload 生成后的反序列化阶段,开销小于 1ms,输出结构化错误列表。 |
闭环自愈反馈机制(Self-Healing Loop):解析失败时的差量重试与动态降级
在面对极端偶发情况(如外部老旧模型接口不支持语法引导采样,或模型输出满足类型契约却未通过复杂的业务逻辑跨字段校验时),系统绝不能直接向用户抛出 500 内部服务器错误,而应触发受控的自愈纠错反馈环(Self-Healing Loop):
【企业级智能体自愈纠错的四步标准闭环】
- 步骤 1:精确提取字段级校验失败清单(Error Localization)
当模式校验抛出异常时,提取结构化报错:包括引发错误的字段路径、期望的约束条件以及模型实际填充的非法值。 - 步骤 2:生成精准的补丁纠错 Prompt(Targeted Healing Prompt)
系统自动组装轻量级的纠错提示词,仅包含发生错误的局部字段及明确修正指引,避免全量上下文重新生成导致的巨大延迟与重复成本。 - 步骤 3:带有限退避的局部纠错重试(Bounded Retry with Context Retention)
智能体将错误诊断注入当前轮次上下文,执行带有温和退避策略的差量重试。自愈重试次数硬编码限定为最多 2 次,防止极端死循环造成 Token 浪费与系统雪崩。 - 步骤 4:优雅降级与人工接入(Fallback & Human Handoff)
若 2 次自愈重试后仍未满足业务校验,系统自动触发降级逻辑:将已成功抽取的无歧义字段持久化入暂存草稿单,标记冲突字段为待人工复核,并向前端界面推送人工微调卡片,确保业务流程不中断。
核心实战代码:企业级大模型结构化输出网关与自愈执行器实现
以下展示了百信企业智能体平台中,基于 TypeScript 实现的多模型自适应结构化输出调度网关与模式校验纠错执行器核心参考实现:
// 企业 ERP 备件采购申报单严格校验模式定义
import { z } from 'zod';

export const ProcurementOrderSchema = z.object({
  requestId: z.string().uuid({ message: "工单追踪 ID 必须为合法 UUID" }),
  department: z.enum(['生产一部', '装备动力科', '质量检测中心', '智能制造研发部'], {
    errorMap: () => ({ message: "部门必须属于预设的合法组织机构列表" }),
  }),
  urgencyLevel: z.enum(['NORMAL', 'HIGH', 'CRITICAL']),
  items: z.array(z.object({
    partNumber: z.string().regex(/^PART-[A-Z0-9]{6,10}$/, { message: "备件编号必须符合 PART-XXXX 命名规则" }),
    partName: z.string().min(2).max(50),
    quantity: z.number().int().positive({ message: "申领数量必须为正整数" }),
    estimatedUnitPrice: z.number().positive({ message: "单价预估必须为正数" }),
  })).min(1, { message: "采购清单至少包含一项备件明细" }),
  reason: z.string().min(5, { message: "申领理由必须详细说明业务背景" }),
});

export type ProcurementOrder = z.infer<typeof ProcurementOrderSchema>;

// 结构化输出执行器与自愈纠错环
export class StructuredAgentExecutor {
  private maxRetries = 2;

  // 执行具备引导约束与自愈验证的结构化抽取
  async executeWithSelfHealing(
    prompt: string,
    modelEndpoint: string,
    authToken: string
  ): Promise<ProcurementOrder> {
    let currentPrompt = prompt;
    let attempt = 0;

    while (attempt <= this.maxRetries) {
      attempt++;

      // 1. 调用底层推理服务,若支持 JSON Schema 则开启强约束
      const rawResponse = await this.callInferenceGateway(currentPrompt, modelEndpoint, authToken);

      // 2. 净化文本,防御极端情况下的非受限模型输出中的 Markdown 反引号
      const sanitized = this.stripMarkdownCodeBlocks(rawResponse);

      // 3. 应用层强校验
      try {
        const parsedJson = JSON.parse(sanitized);
        const validatedData = ProcurementOrderSchema.parse(parsedJson);
        return validatedData; // 校验完全通过,返回可信数据实体
      } catch (err: any) {
        if (attempt > this.maxRetries) {
          throw new Error(`[结构化校验失败] 已达到最大重试次数,错误明细: ${err.message}`);
        }

        // 4. 提取精确字段错误,构造轻量级纠错自愈提示词
        const errorDetails = this.formatValidationErrors(err);
        currentPrompt = `${prompt}\n\n【系统拦截警告 - 上一次输出未能通过模式校验】:\n${errorDetails}\n请仔细修正上述字段,重新输出符合 JSON Schema 规范的完整结构。`;
      }
    }

    throw new Error("未知执行异常");
  }

  // 调用大模型推理网关(配置 response_format 引导采样)
  private async callInferenceGateway(prompt: string, endpoint: string, token: string): Promise<string> {
    const payload = {
      model: "qwen2.5-72b-instruct-awq",
      messages: [{ role: "user", content: prompt }],
      temperature: 0.1,
      response_format: {
        type: "json_object",
      },
    };

    const res = await fetch(endpoint, {
      method: 'POST',
      headers: {
        'Content-Type': 'application/json',
        'Authorization': `Bearer ${token}`,
      },
      body: JSON.stringify(payload),
    });

    if (!res.ok) throw new Error(`推理网关响应异常 HTTP ${res.status}`);
    const data = await res.json();
    return data.choices[0].message.content;
  }

  // 去除可能的外部 Markdown 包装
  private stripMarkdownCodeBlocks(content: string): string {
    const trimmed = content.trim();
    if (trimmed.startsWith('```json') && trimmed.endsWith('```')) {
      return trimmed.slice(7, -3).trim();
    }
    if (trimmed.startsWith('```') && trimmed.endsWith('```')) {
      return trimmed.slice(3, -3).trim();
    }
    return trimmed;
  }

  // 格式化校验异常为结构化提示
  private formatValidationErrors(err: any): string {
    if (err instanceof z.ZodError) {
      return err.errors.map(e => `- 字段 [${e.path.join('.')}]: ${e.message}`).join('\n');
    }
    return `- JSON 语法解析失败: ${err.message}`;
  }
}
制造、金融与政务典型场景的 Schema 约束实战与落地建议
在百信实际协助企业客户落地私有化智能体项目的过程中,不同业务场景对结构化数据的容错阈值与合规深度各不相同。根据真实工程部署经验,给出以下分场景的工程实施建议:
【不同核心场景的 Schema 治理规范】
- 1. 离散制造 MES 工单与设备故障上报:
重点防范“设备编号(Asset ID)”与“故障代码(Fault Code)”的枚举幻觉。在推理层必须通过 Guided Decoding 绑定企业 CMDB 动态导出的当前产线有效设备列表枚举,从源头上阻断智能体捏造不存在的备件型号,确保工单百分之百直接落库。 - 2. 金融凭证核算与交易风控:
重点防范“浮点数精度截断”与“货币符号污染”。严格在 Schema 中禁止模型输出包含千分位逗号或货币符号的字符串,强制以长整型分(Cents)或标准定点数作为输出单位;一旦发生模式校验失败,立即将事务挂起到人工风控复核队列,禁止无限制自动重试。 - 3. 政务跨部门协同与办事材料提取:
重点防范“身份信息格式不合规”与“非空字段漏填”。政务材料抽取通常涉及数十项填报字段,应采用分段 Schema 抽取策略,避免单个庞大的 JSON 超过单次采样窗口导致尾部截断。
综上所述,将大语言模型成功融入企业级严密生产流程的秘诀,不在于追求模型能够写出多么优美的自然语言,而在于“通过推理层语法约束与应用层强类型防御,将大模型的非确定性概率收敛在企业预设的确定性轨道之中”。构建具备语法引导与自愈闭环的执行中枢,是每一位企业 AI 架构师必须筑牢的技术基石。


