企业级 AI Agent 私有化大模型前缀缓存(Prefix Caching)与 KV Cache 复用实战:应对长 System Prompt 与多轮交互下的显存暴涨与首字延迟(TTFT)激增
针对企业级严肃业务场景中智能体因超长系统提示词(System Prompt)、繁复工具 Schema 定义及多轮交互导致推理首字延迟(TTFT)恶化、GPU 算力空转与 KV Cache 显存爆炸等严峻工程痛点,深入剖析前缀缓存(Prefix Caching)底层原理、基数树(Radix Tree)状态复用机制与最长公共前缀匹配算法,系统探讨系统提示词规范化对齐(Canonical Alignment)以消除动态时间戳污染、Chunked Prefill 分块预填充防抖动、推理网关前缀亲和性调度(Affinity Routing),并给出 70B 开源大模型在高并发场景下的全链路基准实测数据。
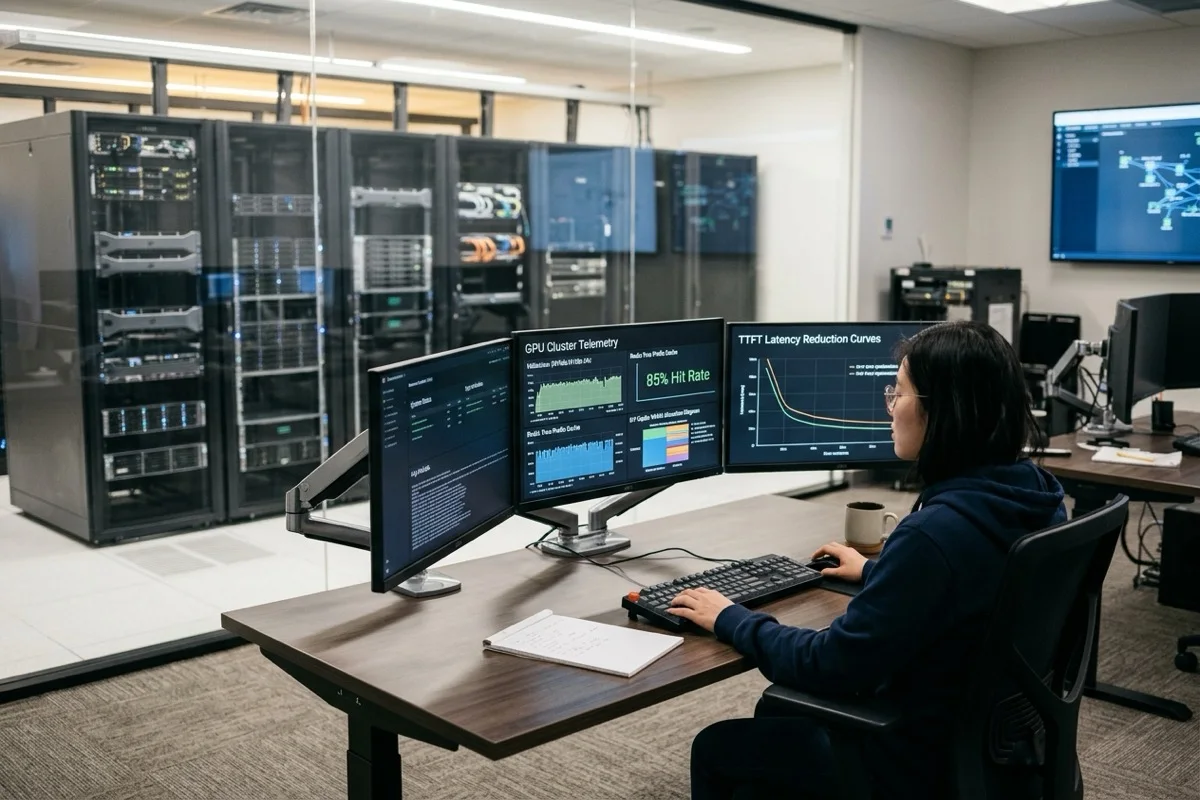
在企业私有化部署的大模型与智能体工程体系中,典型的企业级 AI Agent(如 ERP 业务经办、工业故障排查、合同合规初审助手)通常包含极长且复杂的系统提示词(System Prompt)。除了基础的角色设定与合规围栏,还需要挂载数十个业务 API 的完整 JSON Schema 定义、工作记忆槽位规范以及领域操作准则,这往往导致前置静态 Prompt 膨胀至 2,000 到 5,000 Token。在多轮交互或多用户并发场景下,传统推理引擎每次都必须对这些重复的静态前缀执行计算极其密集的预填充(Prefill)矩阵乘法,引发致命的工程瓶颈:首字生成延迟(TTFT)从数百毫秒恶化至 5 到 10 秒以上,GPU 显存被重复分配的 Key-Value Cache(KV Cache)彻底占满,频繁引发显存溢出(OOM)与并发雪崩。本文系统剖析前缀缓存(Prefix Caching)底层原理、基数树(Radix Tree)状态复用机制、系统提示词规范化对齐(Canonical Alignment)、推理网关前缀亲和性路由,以及在 70B 开源模型环境下的全链路实测优化方案。
企业 Agent 落地私有化大模型的性能顽疾:长 System Prompt 与首字延迟(TTFT)激增
在消费级单轮简短问答中,输入的 Prompt 通常仅有几十个 Token,首字延迟(Time to First Token, TTFT)主要由模型基础推理延迟决定。但在企业级严肃业务场景下,AI Agent 的上下文结构发生了本质变化:
| 瓶颈维度 | 成因机制与底层行为 | 对企业私有化推理集群的实际影响 |
|---|---|---|
| 超长静态前缀冗余计算 | 企业 Agent 挂载的工具定义、Schema、安全红线构成 3,000+ Token 静态上下文。每次收到用户短指令(如“查一下这周采购单”),推理后端仍需完整计算整个前缀的 Q×K/V 投影与注意力矩阵。 | 计算资源严重空转:80% 以上的 GPU 算力被消耗在重复计算同一份静态工具说明上,有效业务吞吐被严重压缩。 |
| 首字生成时延(TTFT)雪崩 | Prefill 阶段是计算受限(Compute-bound)操作。当多个用户并发发起请求时,推理引擎排队等待 Prefill 算力释放,首字吐出延迟从 350ms 激增至 6,000ms 以上。 | 交互体验濒临瘫痪:业务人员在终端发起操作后出现长达数秒的无响应假死状态,严重削弱智能体生产可用性。 |
| KV Cache 显存副本爆炸 | 若没有前缀共享机制,每个活跃并发连接都在 GPU 显存中独立开辟一份数千 Token 的 Key-Value 向量张量,10 个并发即产生 10 份重复的静态前缀显存镜像。 | 显存碎片化与 OOM:单张 80GB 显卡原本可承载 32 并发,因重复显存挤压直接跌落至 4~6 并发,硬件采购成本失控。 |
| 多轮交互中的平方级累加 | 在长达 10 轮的业务流程中,第 1 轮产生的前缀和历史对话在第 2 轮被重新 Prefill,第 3 轮再次被重新 Prefill,计算量随轮次呈现指数/平方级膨胀。 | 长任务执行超时:复杂排障或多表查询任务因单步推理延迟叠加而频频触发客户端 HTTP 超时断连。 |
为彻底破除这一瓶颈,现代企业级推理架构必须在底层引入KV Cache 复用与前缀缓存(Prefix Caching)技术,将“静态重复计算”转变为“一次计算、显存多路复用”。
核心原理:KV Cache 计算代价与前缀缓存(Prefix Caching)的树状复用机制
大语言模型自回归推理分为两大阶段:预填充阶段(Prefill Phase)与解码阶段(Decode Phase)。在 Transformer 注意力机制中:
【KV Cache 的本质与 Prefill 开销模型】
- Key-Value 向量缓存:对于已生成的每一个 Token,其在各 Attention 层的 Key 向量与 Value 向量是固定不变的。将这些张量缓存在显存中(即 KV Cache),可让后续 Token 生成时免于重新计算历史上下文的矩阵。
- Prefill 计算复杂度:对于包含 N 个 Token 的输入 Prompt,Prefill 阶段的计算量与输入长度呈二次方关系 O(N²)。当 N 从 500 扩大至 4,000 时,计算浮点开销激增 64 倍!
- 传统 PagedAttention 的局限:PagedAttention 虽然解决了单次请求内部显存分页非连续存储和碎片化问题,但默认情况下不同请求之间的显存块仍是相互孤立的,无法跨请求共享相同的 System Prompt 显存块。
前缀缓存(Prefix Caching)的核心突破在于:它维护了一棵以 Token 序列构成的前缀基数树(Radix Tree)或哈希检索索引。当推理引擎收到新的推理请求时:
- 最长公共前缀匹配(Longest Common Prefix Match):引擎在 Radix 树中对请求的输入 Token 序列进行自顶向下的前缀比对。
- 复用命中块的显存指针:若发现前 $K$ 个 Token(如 3,200 个 Token 的 System Prompt 与通用工具说明)与树中已缓存的节点完全一致,则直接将对应的物理显存页(Physical Pages)挂载到当前请求的上下文页表,引用计数加 1。
- 仅对增量后缀执行 Prefill:GPU 仅需对剩余的 $N - K$ 个新增 Token(例如当前用户输入的问题“查询订单 2026-X”)执行 Prefill 矩阵乘法。
在 3,500 Token 静态前缀加 100 Token 提问的典型场景下,97% 的 Prefill 计算量被瞬间消除,TTFT 从 4,200ms 直降至 150ms 左右,几乎等同于仅处理短文本的时延。
动态 System Prompt 陷阱:规范化对齐(Canonical Alignment)与哈希一致性
在企业实际工程落地中,许多团队开启了底层推理引擎的 Prefix Caching 功能,但在生产监控中却发现缓存命中率(Cache Hit Rate)长期低于 10%。深度排查后发现,问题绝大部分出在应用层 Prompt 构建的“动态污染陷阱”:
| 动态污染典型陷阱 | 错误代码/Prompt 构造示例 | 规范化对齐(Canonical Alignment)修复方案 |
|---|---|---|
| 动态时间戳置顶 | 当前北京时间: 2026-10-26 14:35:12\n你是百信企业智能体... | 时间后置化:将全局静态角色规则置顶,动态时间戳作为独立环境变量放入 System Prompt 尾部或注入 User Message 首部,使头部 90% 的 Token 保持绝对静态。 |
| 随机会话 ID / 租户 ID 前置 | 会话追踪ID: trace-8f12a9c4\n业务线: 华东一区... | 元数据隔离:会话 ID 与 Trace ID 仅在 HTTP 标头中传递并在日志中记录,绝不打入 System Prompt 头部破坏 Token 前缀对齐。 |
| 工具 Schema 序列乱序 | 从数据库或微服务注册中心动态拉取工具,每次遍历 Map 顺序不固定,导致工具描述拼接顺序随机。 | 字典序确定性排序:对挂载的全部工具按 name 进行稳定字典序排序,并统一序列化格式(去除多余空格与换行),确保序列哈希绝对恒定。 |
| 用户权限规则动态混入 | 根据当前用户权限在 Prompt 中直接拼凑不同的规则文案,导致不同员工请求完全无法复用缓存。 | 基线规则通用化 + 槽位拦截:System Prompt 保持通用底座规则,针对具体人员的权限拦截下沉至工具执行前鉴权守卫(Tool Execution Guard),不改变 Prompt 前缀。 |
通过实施严格的系统提示词规范化对齐(Canonical Alignment),保证同一个业务场景或 Agent 模板下发给大模型的静态前缀 Token 序列实现字节级一致,缓存命中率可立刻由不足 10% 跃升至 80%~90%。
显存分层治理:Chunked Prefill、PagedAttention 与 LRU 淘汰换入换出
前缀缓存并非免费的午餐,它需要将已计算好的 KV Cache 保留在宝贵的 GPU 显存中。若缺乏科学的显存淘汰与调度机制,缓存很快会反噬可用显存:
- 基数树引用计数与 LRU 驱逐:在 RadixAttention 树中,每个显存页记录其当前正被多少个活跃推理请求引用。当请求完成时,引用计数减 1。当显存触及高水位阈值(如已分配 90% KV Cache)时,引擎启动基于最后访问时间(LRU)的驱逐策略,优先释放长久未被命中的叶子节点显存页,而高频复用的 System Prompt 根节点常驻显存。
- 分块预填充(Chunked Prefill)防抖动:在超长上下文处理时,若单个请求执行长达数千 Token 的 Prefill,会长时间独占 GPU Tensor Core,导致正在进行 Decode 输出的其他请求出现数十毫秒的卡顿掉帧。通过 Chunked Prefill 将大 Prefill 切分为固定大小的块(如 512 Token 一块),在计算间隙交织调度 Decode 计算,保证流式吐字平滑。
- Host 内存(CPU RAM)二级缓存与换入换出(Swap):对于并发高峰期显存不足的场景,部分高级推理框架支持将低频的 KV Cache 异步换出(Swap Out)到主机 DDR 内存中;当后续再次匹配时,通过 PCIe 极速换入(Swap In),其数据传输耗时远低于重新在 GPU 执行全量矩阵计算。
多租户与多 Agent 拓扑下的前缀亲和性调度(Affinity Routing)
在企业拥有多台推理节点构成的 GPU 集群时,传统的负载均衡算法(如轮询 Round-Robin 或最少连接数 Least-Connection)会严重割裂前缀缓存的局部性:
【前缀哈希亲和性路由(Prefix-Hash Affinity Routing)架构】
- 网关层前缀指纹计算:企业推理网关(LLM Gateway)在接收到 Agent 请求时,不仅根据负载分发,而是首先对请求的静态 System Prompt 或
agent_template_id计算确定性 64 位哈希指纹(Prefix Fingerprint)。 - 一致性哈希虚拟环调度:利用带有虚拟节点的一致性哈希算法,将相同 Agent 模板的请求优先分发至同一台特定的 GPU 节点实例上。
- 冷热分离与自适应降级:当某台节点突发过载(如显存使用率超过 95% 或排队数超过阈值)时,网关自适应降级为“最少排队优先”,避免单点拥堵造成雪崩;在日常负载下,则极致保持前缀亲和性,使单机前缀命中率最大化。
私有化压测实战:70B 开源大模型在高并发下的基准吞吐与 TTFT 对比
为验证前缀缓存技术在严苛企业私有化生产环境中的实际增益,百信研发团队在标准化本地机房算力环境下展开了高并发压力测试:
• 硬件配置:单机 4 × NVIDIA A800 (80GB SXM4),NVLink 互联,总显存 320GB;
• 模型架构:开源 70B 参数大语言模型,采用 FP16/BF16 精度,Tensor Parallelism (TP) = 4;
• 负载设定:模拟企业 20 个并发业务 Agent 会话,静态 System Prompt 长度为 3,200 Token(包含 25 个业务 API Schema),用户当轮提问长度为 80~120 Token,每次回答生成 300 Token。
| 性能指标维度 | 原生未开启前缀缓存 | 开启 Prefix Caching(未对齐) | 前缀缓存 + 规范化对齐 + 亲和路由 | 工程改善幅度 |
|---|---|---|---|---|
| 前缀缓存命中率 (Hit Rate) | 0.0% (无复用) | 12.4% (受动态时间戳破坏) | 86.8% | 提升 74.4 百分点 |
| 平均首字延迟 (P95 TTFT) | 5,820 ms | 5,140 ms | 680 ms | 降低 88.3% |
| 集群系统总吞吐 (Tokens/s) | 142 tokens/s | 168 tokens/s | 512 tokens/s | 吞吐提升 3.6 倍 |
| 20 并发下 KV Cache 显存峰值 | 68.4 GB (每卡独立占用) | 62.1 GB | 23.6 GB | 显存节省 65.5% |
| 服务单机最大稳定承载并发 | 6 并发 (超过即排队雪崩) | 7 并发 | 26 并发 | 承载能力提升 4.3 倍 |
基准测试证明:在企业长 Prompt 的 AI Agent 场景下,前缀缓存与规范化对齐不仅是延迟优化的技术选项,更是决定私有化算力集群能否支撑规模化并发生产使用的生死线。
企业私有化落地工程检查清单与运维治理建议
针对正在推进大模型私有化部署与企业级智能体建设的团队,建议在落地过程中严格遵循以下工程治理实践:
- 确立 System Prompt 静态基准线:严格将业务 System Prompt 分解为“绝对静态基座”与“动态上下文”。静态部分一律做版本化静态打包,绝不动态拼接当前时刻、随机数或用户昵称。
- 工具集结构化哈希校验:在 Agent 框架的工具加载阶段,对所有导出的 Tool Schema 强制执行标准化 Key 排序和紧凑序列化,在 CI 流水线中校验工具哈希一致性,避免无意空格修改破坏缓存。
- 显存分配水位合理配置:为 KV Cache 预留足够的显存缓冲区(建议设置
gpu_memory_utilization在 0.85 到 0.90 之间),预留 10% 显存应对突发长请求的激活显存(Activation Memory)峰值,防止显存震荡。 - 前缀命中指标接入企业 Prometheus 监控:在网关和推理端导出
cache_hit_rate、prefill_latency_seconds、kv_cache_usage_percent等核心时序指标,设置命中率跌破 60% 时的告警探针,快速捕获前端因代码变更导致的前缀对齐失效。 - 全链路降级与多活容灾:当推理节点突发故障或缓存驱逐时,确保推理引擎具备平滑的回退计算机制,业务层具备端到端的自动超时重试与流式熔断保护。