企业级 AI Agent 私有化部署 GPU 资源池化与弹性切分架构实战:破解 vGPU/MIG 显存隔离、冷启动延迟与并发吞吐瓶颈
针对大型企业在私有化部署 AI Agent 平台时面临的异构模型多卡独占成本高昂、长上下文与并发激增导致 CUDA 显存溢出(OOM)级联雪崩、以及在线潮汐交互与离线知识构建算力割裂等致命瓶颈,系统解构“底层驱动虚拟化切分、Kubernetes 双维度扩展调度器与智能体推理动态租约网关”三层闭环架构。深入剖析时间片轮转、CUDA MPS 进程共享、NVIDIA MIG 硬件硬切分与 vGPU 的适用边界与故障域隔离机制,并提供生产级 TypeScript GPU 资源池化调度引擎、显存安全水位防雪崩反压与分时复用完整工程实现。
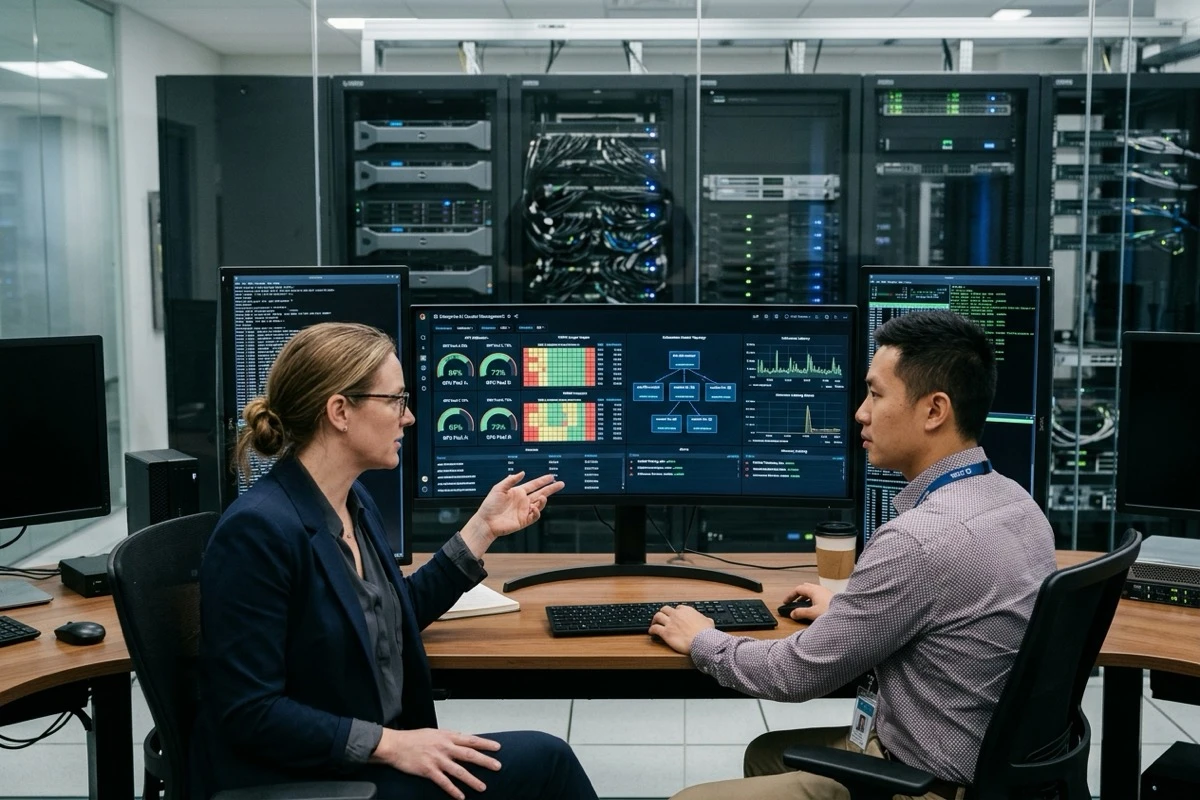
在大型政企与集团型企业推进大模型应用与 AI Agent 平台私有化落地的过程中,算力基础设施的利用率与稳定性往往成为制约规模化推广的致命瓶颈。一个典型的企业级智能体系统,往往集成了参数量从 0.5B 到 70B+ 的多层级异构模型矩阵:包括毫秒级响应的意图识别与语义护栏模型、高频调用的向量嵌入(Embedding)与重排序(Reranker)模型、以及负责复杂规划与业务工具调用的推理大模型。然而,“若按服务独占物理 GPU,轻量级模型单卡算力利用率不足 8%,硬件采购成本极高;若直接多容器混部,CUDA Context 竞争与无硬限制的显存扩张极易在长上下文或并发突发时触发 CUDA Out of Memory (OOM),导致整卡全部 Pod 级联崩溃;而简单的静态切分又面临在线交互峰值排队与夜间离线知识构建算力闲置的冰火两重天”。要彻底破局,必须在底层驱动、Kubernetes 调度编排与上层推理网关之间建立起一套“兼顾硬件级显存隔离、细粒度弹性切分与动态分时复用的 GPU 资源池化架构”。本文深入解构时间片、CUDA MPS、NVIDIA MIG 与 vGPU 的技术边界,并给出生产级 TypeScript / Node.js 弹性调度引擎与分时复用方案的完整工程实现。
企业级 AI Agent 私有化算力困境:小模型独占整卡、大模型显存溢出与长尾任务冷闲置
在传统的通用计算或单一 Web 服务架构中,CPU 与内存的虚拟化已经极其成熟,cgroups 可以在毫秒级对内存与算力施加硬性配额。然而在 GPU 算力体系中,显存(VRAM)与流式多处理器(SM)的物理管理机制大相径庭。在企业级私有化 AI Agent 落地中,基础设施团队通常面临四大严峻困境:
- 异构模型协同带来的显存碎片化与算力失衡: 完整的企业智能体执行链路绝非单一模型,而是多模型流水线。例如用户提问后,先由 0.5B 的分类模型完成意图对齐与安全过滤(占用显存约 1.5GB),再由 BGE-large 提取向量(占用显存约 2.5GB),随后由 14B~32B 的主模型进行长上下文推理与工具规划(量化后占用显存 18GB~36GB)。如果为意图分类和向量化分别独占 80GB 的 A100/H800 卡,显存浪费率超过 95%;但若强行将它们与主模型部署在同一物理卡,又会争抢 SM 核心算力;
- 长上下文推理引发的不确定性显存膨胀与 OOM 级联雪崩: AI Agent 在调用外部 ERP/MES 接口或查阅数百页技术规范时,KV Cache 的显存开销会随着上下文长度呈线性甚至二次方激增。在未做严格显存隔离的混部环境中,当某一租户的智能体触发了 32k 的超长上下文检索时,该 Pod 瞬间申请超额显存,导致底层驱动直接抛出
CUDA out of memory。更致命的是,Linux 内核与 NVIDIA 驱动层此时往往会无差别杀死同卡的其他服务进程,引发整机业务雪崩; - CUDA Context 初始化开销与冷启动高延迟: 在多进程访问同一 GPU 时,每个进程都会在 GPU 上创建独立的 CUDA 上下文,不仅单进程额外损耗数百兆核心显存,而且进程间的时间片上下文切换会导致严重的流水线停顿与延迟抖动。对于要求首字响应时间(TTFT)在 800ms 以内的在线智能体对话而言,频繁的上下文切换会导致 P99 延迟恶化数倍;
- 在线潮汐负载与离线批量构建的算力割裂: 企业的日常智能体交互具备鲜明的潮汐效应:工作时间(9:00 - 18:00)在线推理并发极高,算力池饱水运行;而夜间与周末在线流量暴跌,GPU 处于长时间闲置。与此同时,企业的知识库向量重建、长篇历史文档离线解析与黄金测试集自动化回归评测往往需要海量算力,却因缺乏动态分时复用机制而只能通宵慢速排队。
| 业务模型类型 | 典型参数量与显存底噪 | 业务延迟与 QoS 敏感度 | 传统整卡部署弊端 | 资源池化目标规格 |
|---|---|---|---|---|
| 意图对齐与语义护栏 | 0.5B ~ 1.5B(1.2GB ~ 3.0GB) | 极高(要求 < 30ms 毫秒级返回) | 独占整卡导致算力利用率不足 5% | MPS 共享切片(分配 4GB 显存配额) |
| 向量化(Embedding / Rerank) | 0.3B ~ 1.0B(1.5GB ~ 4.0GB) | 高(要求 < 80ms,高并发批处理) | 无法应对高并发推理吞吐与多实例伸缩 | MIG 1g.10gb 硬件切片或 MPS 多副本 |
| 核心业务推理(14B~32B 量化) | 14B ~ 32B(16GB ~ 36GB) | 中高(TTFT < 800ms,吞吐优先) | 单卡显存剩余碎片无法再运行其他服务 | MIG 3g.40gb 硬件切片(严格硬件隔离) |
| 离线知识重构与测试回归 | 批处理任务,显存按需膨胀 | 低(尽力而为,允许中断与重试) | 常态化抢占在线算力引发主业务抖动 | 分时复用抢占式池化实例(夜间借调) |
GPU 虚拟化与切分核心技术选型:时间片轮转、CUDA MPS、NVIDIA MIG 与 vGPU 深度横向对比
为了在私有化机房实现高效的 GPU 资源复用,业界发展出了多种层级的切分与虚拟化技术。不同技术在隔离级别、性能开销、硬件依赖以及故障域边界上存在根本差异:
- 时间片轮转(Time-Slicing): 这是 Kubernetes 官方早期的默认机制。通过在节点上伪装多个虚拟 GPU 设备,允许多个 Pod 挂载同一张卡。然而,时间片轮转没有任何显存硬隔离机制。所有容器共享同一个全局显存地址空间,只要有一个容器发生内存越界或 OOM,整张卡直接崩溃。此外,时间片切换是在指令流级别粗粒度轮转,高并发下延迟抖动不可控,仅适用于开发测试环境;
- CUDA 多进程服务(CUDA MPS,Multi-Process Server): NVIDIA 针对小算力任务高并发共享推出的优雅方案。MPS 在操作系统内启动一个常驻控制守护进程,所有客户端容器通过 IPC 共享同一个底层 CUDA Context。这不仅消除了数百兆的上下文显存冗余,更允许不同进程的 CUDA Kernel 在同一个 SM 核心上并发交织执行,大幅提升 SM 利用率。从 Volta 架构起,MPS 支持通过环境变量
CUDA_MPS_PINNED_DEVICE_MEM_LIMIT对进程强制设定显存硬上限。但其缺点在于缺少硬件故障隔离:由于共享上下文,若客户端触发非法内存指令导致底层硬件异常,整组 MPS 客户端都会被重置退出; - 多实例 GPU(NVIDIA MIG,Multi-Instance GPU): 从 Ampere 架构(如 A100、A30、H100、H800)引入的硬件级硬切分技术。MIG 将物理 GPU 的显存控制器、高速缓存(L2 Cache)、交叉互连总线以及 SM 算力单元在物理硅片层面严格划分为最多 7 个相互隔离的独立 GPU 实例(GPU Instance)。每个 MIG 实例拥有专属的硬件引擎,一个实例的 OOM 或崩溃完全不会波及任何其他切片,具备与独立物理显卡完全一致的 QoS 保障与故障隔离。其缺点是切片规格预先固定(如 1g.10gb、2g.20gb、3g.40gb),不支持任意连续显存的无级微调;
- 企业级 vGPU(NVIDIA Virtual GPU): 在 VMware ESXi 或 KVM 等 Hypervisor 虚拟化层运行,将物理卡切分为多张虚拟显卡直通给虚机使用。适用于大型私有云已有全套虚拟化资产的企业,但需要昂贵的企业级软件许可(GRID 授权),且虚拟化层带来额外的性能损耗,在纯容器化(Cloud Native)架构中较少作为首选。
| 核心技术维度 | 时间片轮转 (Time-Slicing) | CUDA MPS 守护进程 | NVIDIA MIG 硬件硬切分 | 百信多级混部池化架构 |
|---|---|---|---|---|
| 显存隔离机制 | 无(完全共享,极易 OOM) | 软件级配额上限拦截 | 物理级硅片隔离(专属内存控制器) | 分级隔离:MIG 兜底主推理,MPS 纳管小模型 |
| 算力(SM)调度 | 粗粒度时间片竞争 | 细粒度并发内核交织调度 | 硬件级 SM 算力单元物理绑定 | 基于优先级的动态权重打分与装箱 |
| 故障域边界 | 全局共享(单 Pod 故障击穿全卡) | 共享 Context,单点异常需重启服务 | 完全独立(切片间互不感知) | 核心主推理绝对隔离,边缘辅助自动恢复 |
| 支持的硬件卡型 | 所有 NVIDIA 消费级与企业级 GPU | Volta、Turing、Ampere、Ada 及以上 | 仅限 A100、A30、H100、H800 等计算卡 | 自适应探测底层架构并动态启用最佳方案 |
企业级 GPU 资源池化三层架构蓝图:驱动层切分、Kubernetes 扩展调度器与智能体推理网关
为了兼顾高可用性、硬件隔离强度与资源利用率,百信 AI Agent 平台在私有化部署中采用了“驱动基础设施、集群调度编排、智能体动态推理网关”三层闭环架构:
- 底层驱动与切分层(Driver & Virtualization Layer): 在安装有 NVIDIA GPU Operator 的物理节点上,依据硬件型号实施差异化切分。对于具备 MIG 能力的高端卡(如 A100 80GB),划分为
3g.40gb(运行主大模型)与两个1g.10gb(分别运行 Embedding 与 Rerank),剩余算力作为动态池;对于通用显卡(如 L40S 或 RTX 4090),则由 GPU Operator 注入 MPS 控制容器,以受限内存配额方式拉起常驻推理 Daemon; - 中层调度编排层(Kubernetes Custom Scheduler & Device Plugin): 摒弃粗暴的“按卡分配”模式,基于 Kubernetes Extended Resources 将 GPU 资源抽象为显存(
bxagent.cn/gpu-vram-mb)与核心算力(bxagent.cn/gpu-compute-percentage)两个独立正交维度。调度器插件基于改进的 Bin-packing 装箱算法,在保证不跨物理卡分裂的前提下,优先将高吞吐低显存的辅助模型装入同一个 MPS 节点,将核心长上下文任务精准调度至独立的 MIG 实例; - 顶层推理网关与租约控制器(Inference Gateway & Lease Controller): 部署在 AI Agent 编排引擎与实际推理后端之间。网关维护着所有 GPU 切片的实时动态租约。针对高并发在线请求,网关根据请求的 Token 预估动态分配显存通道;若检测到节点显存逼近安全阈值(85% 水位线),网关主动触发反压(Backpressure),将长文档向量化等离线批处理任务即时挂起,确保核心智能体交互不排队、不 OOM。
显存隔离与防 OOM 核心机制:MIG 硬件切片动态重构、MPS 内存上限配额与主动反压
显存溢出是私有化集群最致命的故障源。为了保证 99.99% 的服务连续性,系统在工程上落地了三重防线:
- 静态配额与 MPS 硬上限注入: 在每个轻量级模型的容器启动脚本中,通过挂载的 IPC 目录强制注入 MPS 环境变量:
当该容器内的推理框架尝试申请第 4097MB 显存时,MPS 驱动层直接在用户空间截断并抛出受限异常,由上层框架捕获后优雅重试,绝对不会影响宿主机其他容器的正常运行;export CUDA_MPS_PINNED_DEVICE_MEM_LIMIT=4096M export CUDA_MPS_ACTIVE_THREAD_PERCENTAGE=30 - 动态 KV Cache 预留与 Token 窗口自适应截断: 推理引擎在初始化加载模型权重后,计算可用物理显存余量。根据并发请求的
max_context_length,动态计算所需 KV Cache 上限。在多智能体并发场景下,若预测下一次推理将突破显存红线,推理网关会介入进行分页注意力(PagedAttention)显存动态置换,将最少使用(LRU)的闲置会话 KV 块临时卸载至系统主机内存(Host Memory),释放 GPU 显存空间; - 基于优先级的自适应反压熔断环(Adaptive Backpressure Ring): 系统将推理任务打上严格优先级标签:
P0-在线业务交互智能体、P1-即时检索向量化、P2-离线批量知识入库。调度器常驻协程每隔 200ms 采集 NVML 硬件显存指标。一旦某物理卡的显存占用率超过 88% 或温度超过 80℃,网关立即向所有 P2 批处理任务下发PAUSE指令,切断输入流,直至显存回落到 70% 的绿色安全水位后再自动恢复。
生产级 TypeScript 企业 GPU 资源池化与自适应调度器引擎实现
以下为在企业私有化环境中落地的核心 GPU 资源池化调度引擎实现。该引擎支持 MIG 物理切片与 MPS 虚拟显存的统筹管理、双维度装箱调度、租约生命周期监控与主动反压控制:
/**
 * 生产级企业 AI Agent GPU 资源池化与自适应调度引擎
 * 职责:纳管异构 GPU 节点、支持 MIG 与 MPS 混合切分、基于显存与算力双维度装箱调度并执行防 OOM 反压
 */

export type GpuPartitionType = 'MIG_HARDWARE' | 'MPS_VIRTUAL' | 'EXCLUSIVE_PHYSICAL';
export type TaskPriority = 'P0_CRITICAL_AGENT' | 'P1_ONLINE_EMBEDDING' | 'P2_OFFLINE_BATCH';

/**
 * GPU 切片实例描述
 */
export interface GpuInstanceSlice {
  sliceId: string;
  nodeName: string;
  physicalGpuIndex: number;
  partitionType: GpuPartitionType;
  totalVramMb: number;
  allocatedVramMb: number;
  computeCapacityPercent: number;
  allocatedComputePercent: number;
  activeLeases: Map<string, GpuLease>;
  isHealthy: boolean;
}

/**
 * 算力租约申请定义
 */
export interface GpuAllocationRequest {
  requestId: string;
  modelName: string;
  priority: TaskPriority;
  requiredVramMb: number;
  requiredComputePercent: number;
  preferredPartition?: GpuPartitionType;
  timeoutMs: number;
}

/**
 * 已分配的算力租约
 */
export interface GpuLease {
  leaseId: string;
  sliceId: string;
  requestId: string;
  modelName: string;
  priority: TaskPriority;
  allocatedVramMb: number;
  allocatedComputePercent: number;
  createdAt: number;
  expiresAt: number;
}

/**
 * 调度决策结果
 */
export interface SchedulingDecision {
  success: boolean;
  lease?: GpuLease;
  assignedSlice?: GpuInstanceSlice;
  backpressureTriggered?: boolean;
  rejectionReason?: string;
}

export class GpuResourcePoolScheduler {
  // 维护所有纳管的 GPU 切片拓扑
  private slices: Map<string, GpuInstanceSlice> = new Map();
  // 显存安全水位线阈值(超过此阈值触发 P2 任务反压)
  private readonly backpressureVramRatio = 0.85;

  /**
   * 注册物理或虚拟切片节点
   */
  public registerSlice(slice: Omit<GpuInstanceSlice, 'activeLeases' | 'allocatedVramMb' | 'allocatedComputePercent'>): void {
    const fullSlice: GpuInstanceSlice = {
      ...slice,
      allocatedVramMb: 0,
      allocatedComputePercent: 0,
      activeLeases: new Map(),
      isHealthy: true
    };
    this.slices.set(fullSlice.sliceId, fullSlice);
  }

  /**
   * 核心调度入口:执行双维度筛选、Bin-packing 装箱评分与配额锁定
   */
  public allocate(request: GpuAllocationRequest): SchedulingDecision {
    const now = Date.now();
    this.cleanupExpiredLeases(now);

    // 1. 过滤出健康且满足基础约束的候选切片
    const candidates = Array.from(this.slices.values()).filter(slice => {
      if (!slice.isHealthy) return false;
      if (request.preferredPartition && slice.partitionType !== request.preferredPartition) {
        return false;
      }
      const availableVram = slice.totalVramMb - slice.allocatedVramMb;
      const availableCompute = slice.computeCapacityPercent - slice.allocatedComputePercent;
      return availableVram >= request.requiredVramMb && availableCompute >= request.requiredComputePercent;
    });

    // 2. 如果候选集为空,评估是否需要对低优先级任务执行反压与抢占
    if (candidates.length === 0) {
      if (request.priority === 'P0_CRITICAL_AGENT') {
        const evicted = this.attemptEvictP2Tasks(request.requiredVramMb, request.requiredComputePercent);
        if (evicted) {
          // 抢占成功后递归尝试二次分配
          return this.allocate(request);
        }
      }
      return {
        success: false,
        rejectionReason: `GPU 算力池不足:当前无切片可满足 ${request.requiredVramMb}MB 显存与 ${request.requiredComputePercent}% 算力请求`
      };
    }

    // 3. 基于最优装箱(Best-Fit Bin-packing)打分:优先选择分配后碎片最小的切片
    candidates.sort((a, b) => {
      const remainingVramA = (a.totalVramMb - a.allocatedVramMb) - request.requiredVramMb;
      const remainingVramB = (b.totalVramMb - b.allocatedVramMb) - request.requiredVramMb;
      return remainingVramA - remainingVramB;
    });

    const selectedSlice = candidates[0];

    // 4. 检查是否触发安全水位线反压警报
    const projectedUsage = (selectedSlice.allocatedVramMb + request.requiredVramMb) / selectedSlice.totalVramMb;
    const isBackpressure = projectedUsage >= this.backpressureVramRatio;

    // 5. 生成租约并原子更新切片状态
    const lease: GpuLease = {
      leaseId: `lease_${now}_${Math.random().toString(36).substring(2, 7)}`,
      sliceId: selectedSlice.sliceId,
      requestId: request.requestId,
      modelName: request.modelName,
      priority: request.priority,
      allocatedVramMb: request.requiredVramMb,
      allocatedComputePercent: request.requiredComputePercent,
      createdAt: now,
      expiresAt: now + request.timeoutMs
    };

    selectedSlice.allocatedVramMb += request.requiredVramMb;
    selectedSlice.allocatedComputePercent += request.requiredComputePercent;
    selectedSlice.activeLeases.set(lease.leaseId, lease);

    return {
      success: true,
      lease,
      assignedSlice: selectedSlice,
      backpressureTriggered: isBackpressure
    };
  }

  /**
   * 释放已分配租约
   */
  public releaseLease(leaseId: string): boolean {
    for (const slice of this.slices.values()) {
      const lease = slice.activeLeases.get(leaseId);
      if (lease) {
        slice.allocatedVramMb = Math.max(0, slice.allocatedVramMb - lease.allocatedVramMb);
        slice.allocatedComputePercent = Math.max(0, slice.allocatedComputePercent - lease.allocatedComputePercent);
        slice.activeLeases.delete(leaseId);
        return true;
      }
    }
    return false;
  }

  /**
   * 自动回收超时超期租约,防止孤儿连接泄漏显存
   */
  private cleanupExpiredLeases(currentTime: number): void {
    for (const slice of this.slices.values()) {
      for (const [leaseId, lease] of slice.activeLeases.entries()) {
        if (currentTime > lease.expiresAt) {
          slice.allocatedVramMb = Math.max(0, slice.allocatedVramMb - lease.allocatedVramMb);
          slice.allocatedComputePercent = Math.max(0, slice.allocatedComputePercent - lease.allocatedComputePercent);
          slice.activeLeases.delete(leaseId);
        }
      }
    }
  }

  /**
   * 针对 P0 级实时在线智能体任务,驱逐运行中的 P2 离线批处理任务
   */
  private attemptEvictP2Tasks(neededVram: number, neededCompute: number): boolean {
    let freedVram = 0;
    let freedCompute = 0;
    const leasesToEvict: string[] = [];

    for (const slice of this.slices.values()) {
      for (const [leaseId, lease] of slice.activeLeases.entries()) {
        if (lease.priority === 'P2_OFFLINE_BATCH') {
          leasesToEvict.push(leaseId);
          freedVram += lease.allocatedVramMb;
          freedCompute += lease.allocatedComputePercent;
          if (freedVram >= neededVram && freedCompute >= neededCompute) {
            break;
          }
        }
      }
      if (freedVram >= neededVram && freedCompute >= neededCompute) {
        break;
      }
    }

    if (freedVram >= neededVram && freedCompute >= neededCompute) {
      for (const id of leasesToEvict) {
        this.releaseLease(id);
      }
      return true;
    }
    return false;
  }
}
混合负载分时复用实战:在线智能体实时交互与离线知识向量化批处理的平滑降级
在企业日常运转中,在线推理与离线计算是算力消耗的两极。百信 AI Agent 平台通过“日间在线优先、夜间算力借调、动态分时复用”的策略,将私有化集群的整体 GPU 硬件综合利用率由 18% 提升至 72% 以上:
- 白昼模式(08:30 - 19:30):在线交互绝对隔离与预热保活: 在业务高峰期,调度引擎将 80% 的 GPU 算力严格锁定在 P0/P1 在线实例中。核心主模型与语义护栏模型采用常驻内存(Keep-Alive)策略,严禁冷启动释放。离线知识库更新任务被限制在专用的单卡或小切片中运行,且执行并发严格控制在单线程,确保绝不挤占公共 PCIe 带宽与网络总线;
- 夜间借调模式(20:00 - 次日 07:00):离线批量流水线自动扩容: 当网关监测到连续 30 分钟在线交互请求降至基线 10% 以下时,集群控制器自动触发弹性伸缩策略:将原本运行备用在线推理的 MIG 切片临时重新解构为大颗粒度批处理实例,挂载进 Ray 或 vLLM 离线并发推理队列,以 100% 满负荷状态极速处理企业海量技术文档的 OCR 解析、分块向量化(Embedding)与历史会话归档质检;
- 秒级抢占与状态冻结(State Freezing)恢复机制: 在夜间批处理期间,若遭遇突发在线业务(如夜班生产线急停故障诊断 Agent 被唤醒),网关基于租约抢占机制,向正在跑批的离线任务发送
SIGSTOP信号,将其显存状态安全转储至主机 NVMe SSD 交换空间,1.5 秒内腾出显存通道优先响应在线紧急任务。待在线交互完毕后,自动发送SIGCONT恢复批处理流水线,实现零人工介入的无感动态复用。
生产环境部署清单、Prometheus 指标观测与运维避坑指南
在私有化物理机房或专有云落地 GPU 池化时,架构师与运维团队应当严格依据以下工程检查清单实施交付验收:
| 检查阶段 | 核验项目与标准 | 核心命令或配置文件依据 | 常见踩坑点与避坑策略 |
|---|---|---|---|
| 宿主机驱动与固件 | NVIDIA 驱动版本 ≥ 535.129,CUDA ≥ 12.2,支持 MIG 模式 | nvidia-smi -mig 1 校验是否支持开启 | 消费级 RTX 卡不支持开启硬件 MIG;需走 MPS 隔离方案 |
| MPS 守护进程环境 | 验证宿主机 /tmp/nvidia-mps 管道与控制套接字正常通信 | nvidia-cuda-mps-control -d | 容器未共享 IPC 命名空间会导致客户端无法发现 MPS 控制器 |
| K8s 扩展资源暴露 | Node 节点上报 nvidia.com/mig-3g.40gb 或显存虚拟切片资源 | kubectl describe node <node-name> | GPU Operator ConfigMap 遗漏 MIG 策略导致切片无法上报 |
| 监控指标告警链路 | Prometheus + DCGM-Exporter 实时采集各切片 VRAM 与 SM 利用率 | DCGM_FI_DEV_FB_USED、DCGM_FI_DEV_GPU_UTIL | 告警阈值配置过高;建议显存占用达到 85% 立即触发预警 |
参考文献与规范依据
- NVIDIA Corporation. (2024). NVIDIA Multi-Instance GPU (MIG) User Guide: Architecture, Management, and Capabilities. NVIDIA Documentation Hub.
- NVIDIA Corporation. (2023). Multi-Process Service (MPS): CUDA Application Architecture and Resource Allocation. NVIDIA Developer Technical Report.
- Kubernetes Community. (2025). Dynamic Resource Allocation (DRA) and Extended Device Plugins for Specialized Hardware. Cloud Native Computing Foundation (CNCF).
- Kwon, W., Li, Z., Zhuang, S., et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. In Proceedings of the ACM SIGOPS 29th Symposium on Operating Systems Principles (SOSP '23).
- 百信企业智能体私有化部署公开指南与算力规范:https://bxagent.cn/private-deployment/ 与 https://bxagent.cn/product/。