企业级 AI Agent 全链路可观测性实战:OpenTelemetry 扩展、多步推理追踪与 Token 消耗归因
针对企业级 AI Agent 复杂长链路多步决策中的黑盒难复现、慢调用瓶颈难定位以及大模型 Token 资源消耗缺乏精细归因等运维痛点,系统拆解基于 OpenTelemetry 规范的 GenAI 语义约定扩展方案。深入剖析涵盖 Workflow、Step、Retrieval、LLM 与 Tool 的分层嵌套 Span 拓扑设计、W3C Trace Context 跨异步协程与外部微服务的上下文透传机制、结合租户与 Prompt 模板版本的 Token 消耗多维度量,并给出内存级数据动态脱敏与自适应尾部采样策略,助力企业构建高可用、可解释的生产级智能体观测底座。
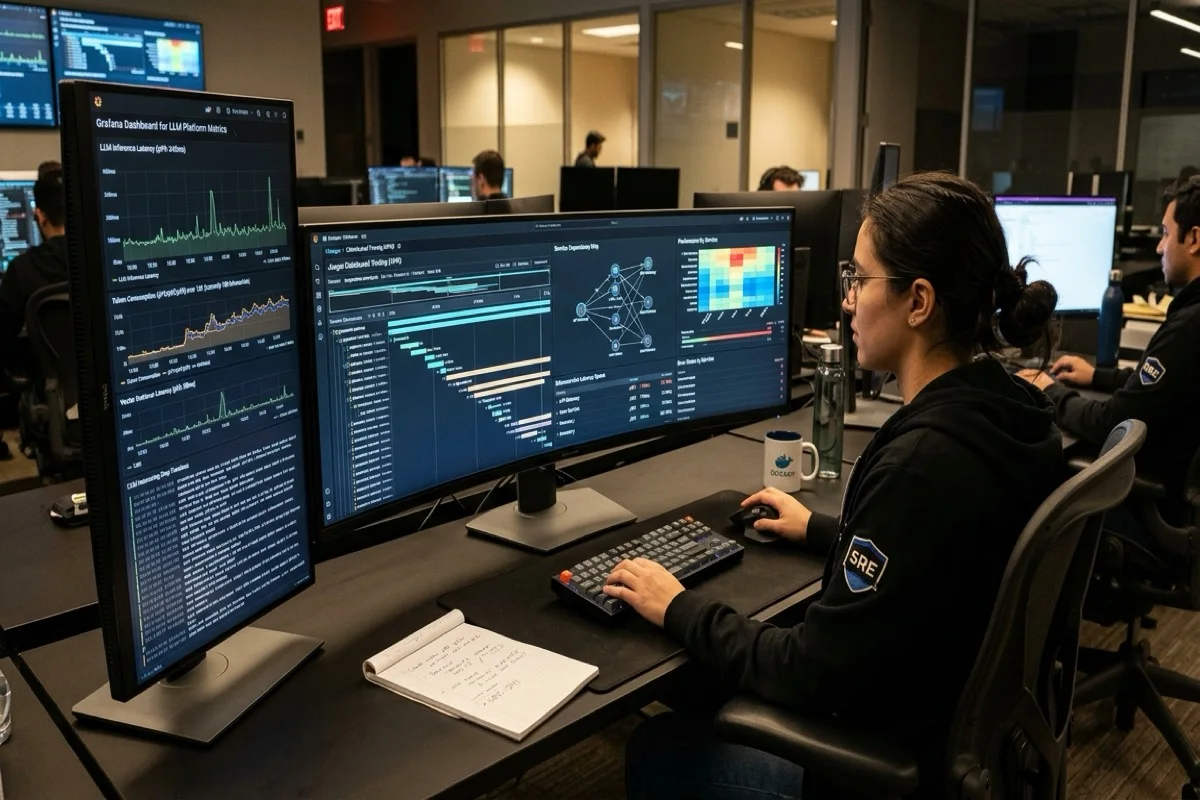
随着大模型与自主智能体(AI Agent)在企业级核心业务系统(如 ERP、CRM、知识治理平台)中的纵深落地,系统架构正在从传统的“确定性微服务调用”演变为“动态、长链路、多步循环的非确定性智能编排”。然而,当企业将 Agent 投产后,IT 运维与研发团队普遍遭遇了前所未有的“黑盒坍塌”困境:某次客户报销审批智能体耗时超过 15 秒,传统应用性能监控(APM)只能捕获到一个超时的 HTTP 入口,根本无法拆解是语义检索超时、大模型推理拥堵、还是工具参数幻觉引发了多轮无效重试;更严重的是,月底财务与技术审计要求核算各事业部的 Token 资源开销时,现有的分布式链路追踪系统无法提供细粒度的 Token 消耗归因与 Prompt 模板版本关联。本文结合百信企业智能体平台在大型政企私有化部署中的工程实践,系统详解如何基于 OpenTelemetry 标准扩展 GenAI 语义约定(Semantic Conventions),构建贯穿“用户请求 — 知识检索 — 大模型推理 — 工具执行 — 异常自愈”的端到端全链路可观测性架构,实现毫秒级瓶颈排查与精细化 Token 成本核算。
传统 APM 遭遇 GenAI 黑盒:AI Agent 全链路可观测性的四大断层
在传统的微服务架构中,分布式追踪(Distributed Tracing)基于 Google Dapper 论文与 W3C Trace Context 规范,通过在 HTTP/RPC 头部传递 traceparent,即可轻松串联起由数据库、缓存及下游微服务构成的调用树(DAG)。然而,当智能体引入了自主规划(Planning)、记忆检索(Memory RAG)、工具反射调用(ReAct Loop)等动态机制后,传统的链路监控工具(如 SkyWalking、Pinpoint、传统 Jaeger 探针)暴露出四大系统性断层:
| 治理维度 | 传统微服务 APM 局限(反模式) | 企业级 AI Agent 全链路可观测性(规范实践) |
|---|---|---|
| 拓扑结构表达 | 仅记录静态扁平的 HTTP/gRPC 网络跳数,无法表达智能体多轮思考(Thought-Action-Observation)的动态自循环拓扑。 | 分层嵌套 Span 架构:定义根工作流(Workflow)、规划步骤(Step)、模型生成(GenAI Client)、知识检索(Retrieval)与工具调用(Tool)的严格层级。 |
| 资源度量颗粒度 | 仅度量 CPU、内存与网络吞吐,完全缺乏输入/输出 Token 计数、KV Cache 命中率及推理显存占用等大模型核心指标。 | Token 维度下钻计量:实时采集 Prompt Tokens、Completion Tokens、Cache Read Tokens,并关联业务租户与具体 Prompt 模板版本。 |
| 非结构化语义留存 | 将 LLM 调用视同普通远程调用,丢失了提示词组装过程、模型上下文衰减度、重排序评分及工具入参校验详情。 | 语义事件与属性映射:遵循 OpenTelemetry GenAI 规范,记录模型参数(Temperature、Top-p)、检索召回分值分布及工具执行状态。 |
| 合规与隐私治理 | 全量打印日志导致敏感数据(身份证号、商业机密、手机号)明文落盘;或一刀切关闭日志导致故障无法复现。 | 探针级动态掩码与智能采样:在 OTel 收集器(Collector)前置执行敏感数据脱敏,对慢调用与异常链路实施 100% 靶向保留。 |
显而易见,企业要掌控 AI Agent 的运行质量,必须摆脱单纯将大模型当作“黑盒 HTTP 接口”的监控思路,建立一套语义感知型(Semantic-Aware)的分布式链路追踪体系。
基于 OpenTelemetry 的 GenAI 语义约定扩展与 Span 分层规范
云原生计算基金会(CNCF)的 OpenTelemetry 社区近年来正式推出了针对生成式 AI 系统的语义约定规范(Semantic Conventions for Generative AI Systems)。在百信企业智能体平台中,我们在此标准基础上进一步扩展,形成了五层标准的 Span 拓扑树:
【企业级 AI Agent 分层 Span 拓扑规范】
- 1. 根跨度(Root Span -
agent.workflow):
代表终端用户发起的一次完整业务交互会话。必须附带tenant.id(租户编号)、user.id(操作员编号)、session.id(会话ID)及workflow.name(业务工作流名称)。记录整体响应延迟与最终业务完成状态。 - 2. 步骤跨度(Step Span -
agent.step):
在多轮 ReAct 或 Plan-and-Solve 执行中,每个独立的决策循环封装为一个 Step Span。属性包含step.index(步骤序号)、step.type(planning / tool_execution / synthesis)以及是否触发了熔断防御。 - 3. 检索跨度(Retrieval Span -
gen_ai.retrieval):
涵盖知识库向量化查询、混合检索与重排序全过程。必须记录db.system(如 milvus/qdrant)、retrieval.query(改写后查询词)、retrieval.top_k、以及召回切片的最高分值与重排耗时。 - 4. 模型推理跨度(LLM Span -
gen_ai.client):
直连私有化推理网关(vLLM / TGI)或商业模型 API。标准化记录gen_ai.system、gen_ai.request.model、gen_ai.usage.input_tokens、gen_ai.usage.output_tokens以及首字到达时间(TTFT, Time-to-First-Token)。 - 5. 工具调用跨度(Tool Span -
agent.tool_call):
下发给业务系统(ERP、OA、MES)的动作。记录tool.name、tool.parameters(脱敏后)、tool.execution_status与业务接口返回耗时。
通过清晰的 Span 分级,研发与运维人员在 Jaeger 或 Grafana Tempo 中查看调用链时,能够以瀑布图形式直观洞察智能体在每一秒钟的具体动作:究竟是耗费在知识库向量检索,还是在等待下游 ERP 接口返回,亦或是大模型在逐字生成。
多步推理与长链路上下文透传:W3C Trace Context 跨系统打通与异步协程生命周期绑定
在异步并发的 Python(Asyncio / FastAPI)或 Go / Node.js 运行时中,由于工具执行可能涉及多线程工作池、事件循环或消息队列分发,极易发生“上下文丢失(Context Loss)”,导致下游生成的 Span 成为无法挂载到父链路上的孤儿节点。为此,必须建立严格的上下文透传中间件机制:
# 文件位置:bxagent/observability/tracer.py
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode
import time

tracer = trace.get_tracer("bxagent.core.workflow", "1.0.0")

class AgentTraceContext:
    # 执行大模型推理并自动注入标准化 GenAI 属性
    @staticmethod
    async def trace_llm_inference(model_name: str, prompt_tokens: int, call_fn):
        with tracer.start_as_current_span("gen_ai.client.generate") as span:
            span.set_attribute("gen_ai.system", "vllm")
            span.set_attribute("gen_ai.request.model", model_name)
            span.set_attribute("gen_ai.usage.input_tokens", prompt_tokens)

            start_time = time.perf_counter()
            try:
                result = await call_fn()
                # 记录模型生成的补全 Token 数量与首字时延
                span.set_attribute("gen_ai.usage.output_tokens", result.output_tokens)
                span.set_attribute("gen_ai.response.finish_reason", result.finish_reason)
                span.set_status(Status(StatusCode.OK))
                return result
            except Exception as e:
                # 捕获推理异常,如显存溢出(OOM)或上下文超长截断
                span.record_exception(e)
                span.set_status(Status(StatusCode.ERROR, str(e)))
                raise e
当下发 HTTP 工具调用(如向企业 ERP 系统发送对账查询)时,可观测性组件必须将当前的 TraceContext 编码为标准 W3C 头部(traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01)随请求发出。这使得外部业务系统的微服务日志能够与 AI Agent 的推理步骤在同一个 TraceId 下无缝缝合,彻底消除跨系统排查故障时的皮球推诿。
细粒度 Token 消耗归因与成本多维核算引擎实战
在企业级私有化集群或专有云上,算力并不是无限的。管理层往往需要明确回答两个核心业务问题:“哪一个业务部门消耗了最多的模型算力?” 以及 “哪一个 Agent 场景存在严重的 Token 浪费或低效提示词?”。如果只有粗粒度的总请求数统计,企业将无法实现精细化的 IT 成本分摊(Cost Allocation)。
| 分析维度 | 下钻字段(OTel Attributes) | 业务诊断与优化收益 |
|---|---|---|
| 按租户/组织归因 | tenant.id, dept.code | 精确核算子公司与部门的月度 Token 额度消耗,支持集团内部 IT 算力结算与超额流控预警。 |
| 按 Prompt 模板版本 | prompt.template.id, prompt.version | 对比新旧版本提示词的平均输入 Token 增幅与输出质量,拦截因系统提示词无序膨胀导致的显存暴涨。 |
| 按执行步数与循环率 | agent.step.count, loop.detected | 识别单次会话步数异常偏高的长尾请求,及时发现因工具参数解析失败引发的无意义多轮自愈重试。 |
| 前缀缓存收益评估 | llm.kv_cache.hit_tokens | 度量 vLLM / SGLang 的 Prefix Caching 实际复用率,量化评估固定系统提示词与上下文缓存策略的节能效果。 |
通过实时聚合这些 Span 属性,运维平台可以构建出多维度的“Token 资产消耗大屏”,并在单次调用消耗超过预警阈值(如单次会话超过 32k Tokens)时自动向业务管理员发出高消耗熔断提示。
企业安全脱敏、合规审计与自适应动态采样策略
在企业级环境中,全链路追踪与数据安全合规之间往往存在天然的张力:为了方便排查问题,工程师希望在 Span 中完整记录用户原始输入和下游接口返回;但根据《网络安全法》与《个人信息保护法》,员工身份证、手机号、合同金额等敏感信息(PII)严禁未经脱敏即存入外部 APM 日志库。
【企业级可观测性安全与采样三大黄金法则】
- 1. 内存级探针前置动态脱敏(In-Memory Masking):
在将 Prompt 或工具调用参数写入 Span 属性之前,由内置安全拦截器基于预置正则表达式(如手机号、银行卡、身份证)与语义命名实体识别(NER)执行掩码处理(如138****0000),确保脱敏操作在内存中即刻完成,绝不向存储层泄漏明文。 - 2. 区分审计通道与诊断通道(Audit vs Tracing Separation):
将合规审计日志与工程性能追踪物理分离。合规审计日志采用国密加密存储于只读合规库,而 APM 追踪链路仅保留脱敏后的语义指纹、Token 指标与耗时,防止运维工程师通过 APM 界面越权窥探业务机密。 - 3. 尾部自适应采样(Tail-Based Adaptive Sampling):
针对正常、高频且耗时低于 1.5 秒的简单会话,按 5%~10% 的低比例进行随机采样以节约存储开销;而对于耗时超过 3 秒的慢调用、HTTP 状态码异常、触发模型重试或参数校验失败的异常会话,实施 100% 全量保留,确保每一个故障现场都拥有完整的追溯数据。
私有化全栈可观测性落地架构与选型决策对比
针对不同的企业研发规模与基础设施现状,落地方案通常有三种不同路径:基于标准 OpenTelemetry 自建开源栈、采用第三方专有 LLM 监控平台、或在原有微服务 APM 上打补丁改造。其核心优劣势对比如下:
| 选型方案 | 技术栈组合 | 核心优势 | 潜在瓶颈与适用场景 |
|---|---|---|---|
| 云原生标准开源栈(推荐) | OpenTelemetry SDK + OTel Collector + Tempo / ClickHouse + Grafana | 无厂商锁定、完全符合 CNCF 标准、生态工具完备、支持私有化机房低成本海量存储与高并发检索。 | 需要研发团队对 OTel 语义扩展有较深理解,适合中大型企业建立统一可观测性平台。 |
| 专用 LLM-Ops 平台 | Langfuse / Arize Phoenix / LangSmith 等私有化版本 | 开箱即用、界面原生支持 Prompt 调试、版本评测与人工标注评分。 | 与企业既有微服务 APM 割裂,形成数据孤岛;大规模海量数据下私有化部署运维成本较高。 |
| 传统 APM 侵入式改造 | SkyWalking / Pinpoint / 自研微服务拦截器 | 完全沿用企业现存监控平台,无需部署额外基础设施。 | 缺乏非结构化语义支持,难以展示动态推理循环拓扑,Token 归因与 Prompt 版本维护成本极高。 |
百信企业智能体平台的实践证明:采用标准 OpenTelemetry 语义扩展 + 私有化 ClickHouse / Tempo 高效存储,是大型企业兼顾性能分析、Token 成本核算、跨系统微服务联动与安全数据合规的最优工程解法。通过全链路可观测性,企业不仅能够彻底驱散 AI Agent 的黑盒阴霾,更能让每一次智能决策都有迹可循、每一笔算力开销都明晰可见。